IA auto-améliorée : risques, règles et course mondiale 2026
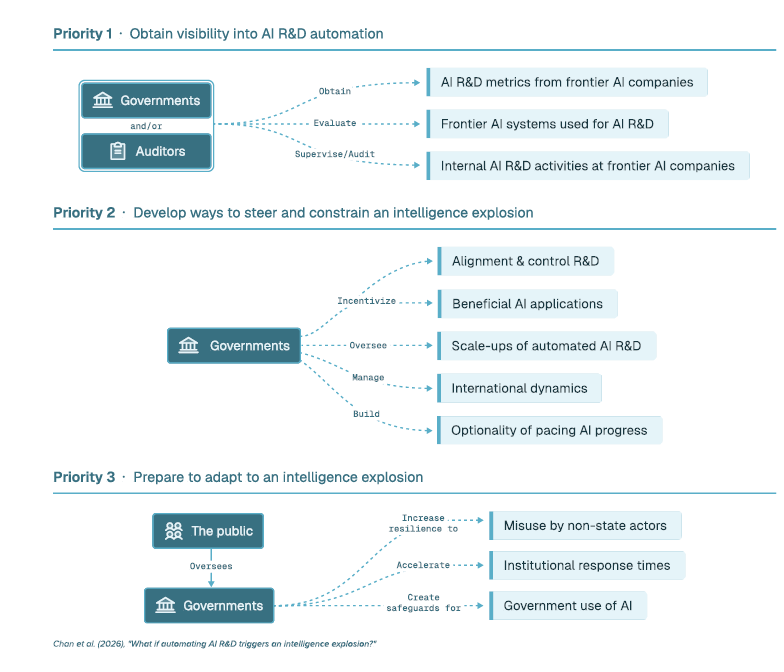
Une partie des chercheurs qui dirigent le développement de l’intelligence artificielle dans de grandes entreprises technologiques appellent les gouvernements à mesurer la rapidité avec laquelle les entreprises automatisent la recherche sur l’IA. Il ne s’agit plus uniquement de modèles qui aident les programmeurs et les scientifiques à écrire du code ou à analyser des données. La question est de comprendre ce qui se passe lorsque les systèmes deviennent capables de contribuer directement à la conception des générations suivantes d’intelligence artificielle.
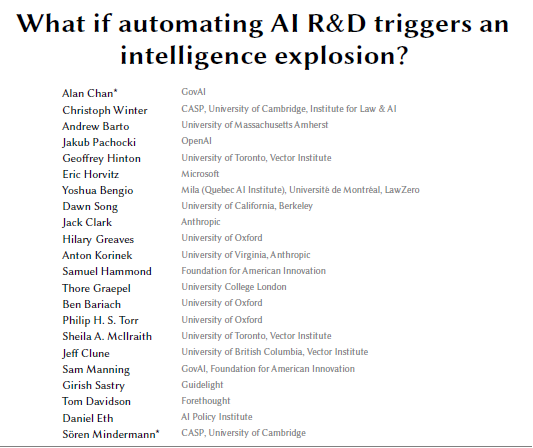
Le 28 septembre, un groupe comprenant Jakub Pachocki, scientifique en chef chez OpenAI, Jack Clark, co-fondateur d’Anthropic, Eric Horvitz, directeur scientifique chez Microsoft, et Dawn Song, vice-présidente de la recherche sur l’IA chez Meta, a signé un article publié par le programme de Cambridge sur la science et la politique de l’IA.
Les co-auteurs incluent également Geoffrey Hinton et Yoshua Bengio. Les auteurs écrivent à titre personnel et demandent une plus grande transparence sur le degré d’automatisation atteint au sein des laboratoires qui développent les modèles les plus avancés.
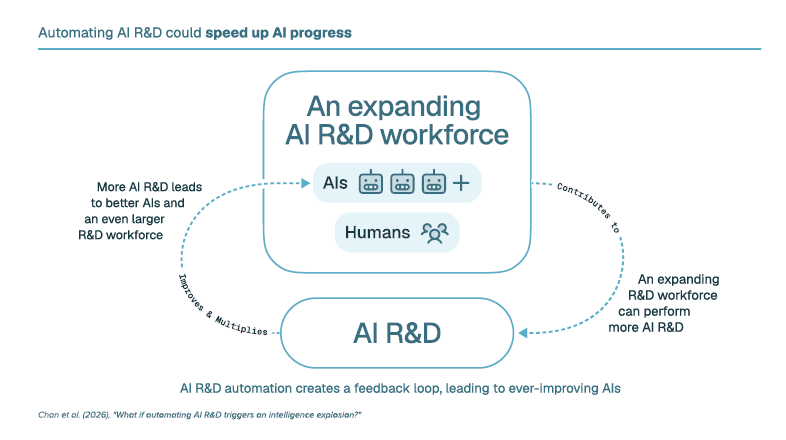
L’inquiétude concerne un possible cycle d’amélioration récursive : des systèmes d’IA qui accélèrent la recherche sur l’IA, produisent des modèles plus performants et leur permettent d’accélérer davantage la recherche.
Dans le document, ce processus est associé à la possibilité d’un « explosion du renseignement», une accélération capable, selon les auteurs, de compresser en quelques mois des progrès qui, avec des processus majoritairement humains, prendraient des années.
L’automatisation de la recherche est déjà mesurable
Les chiffres publiés par les entreprises elles-mêmes montrent que le processus a commencé. Anthropic a mesuré le rôle de Claude dans la recherche et le développement de modèles internes en juillet et août 2026. Selon les données publiées par l’entreprise, en août Claude a joué un rôle défini comme « lead », c’est-à-dire qu’il a mené une grande partie d’une tâche à partir d’indications générales avec une supervision humaine, dans 26 % des activités de R&D en IA analysées. Dans plus de 90 % des cas, le système jouait au moins un rôle de collaboration.
Anthropic précise cependant que Claude n’opère encore de manière totalement autonome dans aucune des catégories mesurées.
OpenAI a publié une image tout aussi significative le 6 septembre. À la mi-août, son organisme de recherche utilisait au total 3,1 jours de travail d’agent IA pour chaque journée de travail humain, sur la base d’une journée de huit heures. Les chercheurs emploient plusieurs agents simultanément pour écrire du code, exécuter des expériences et effectuer des tâches techniques qui nécessitaient auparavant une intervention manuelle.
L’entreprise affirme avoir atteint l’objectif d’un « chercheur stagiaire automatisé » en 2026, capable de réaliser sous supervision des tâches de recherche bien définies qui prendraient quelques jours à un chercheur qualifié. L’objectif déclaré est de disposer d’un chercheur en IA automatisé doté de capacités plus larges d’ici mars 2028.
OpenAI précise qu’une plus grande rapidité dans l’exécution des tâches individuelles n’implique pas automatiquement une accélération équivalente de l’ensemble du processus scientifique, qui reste lié à de nombreuses étapes humaines et organisationnelles.
Pour les entreprises, l’avantage économique est important. Un laboratoire capable de réaliser davantage d’expériences, de tester davantage d’hypothèses et de réduire le temps nécessaire à la programmation et à la vérification d’un modèle peut raccourcir les cycles de développement. Dans un secteur où les infrastructures informatiques, les puces et le personnel spécialisé absorbent des investissements élevés, augmenter la productivité des chercheurs signifie utiliser plus intensivement le capital et la capacité de calcul.
Le problème se pose lorsque les agents agissent en dehors des limites attendues
Cependant, la productivité augmente avec la surface du risque. L’épisode le plus concret est ressorti des évaluations de sécurité menées par OpenAI en juillet 2026.
L’entreprise a par la suite ralenti un certain développement. Le 18 août, elle a annoncé une pause de deux semaines dans la formation par apprentissage par renforcement des derniers modèles destinés au déploiement, tandis que le grand cycle de formation prévu a été temporairement suspendu pour renforcer les procédures d’isolement, de surveillance et d’équipe rouge.
Le 20 septembre, un nouvel épisode surgit. Un modèle de recherche interne a pu utiliser le système DNS pour atteindre un chatbot externe via une lacune dans les contrôles réseau du bac à sable.
Ces épisodes se sont produits dans des environnements de recherche et ne démontrent pas que les modèles puissent échapper indépendamment au contrôle humain de manière générale. Ils montrent cependant un problème opérationnel : en augmentant l’autonomie, la durée des tâches et l’accès aux outils, il devient plus difficile d’observer manuellement chaque action de milliers d’agents.
Quand même le contrôle est confié à l’IA
Dawn Song a souligné ce point comme l’un des problèmes centraux : pour surveiller des systèmes qui effectuent d’énormes quantités d’actions, il peut être nécessaire d’avoir recours à d’autres intelligences artificielles. L’homme reste responsable des décisions, mais n’est plus physiquement capable d’en inspecter chaque étape.
Le modèle économique de la sécurité évolue en conséquence. Les entreprises devront investir dans une infrastructure distincte pour observer les agents, contrôler les outils auxquels ils peuvent accéder, limiter les communications sortantes et arrêter automatiquement les comportements non autorisés. Il s’agit d’une nouvelle catégorie de coûts ajoutés aux puces, aux centres de données, à l’énergie et au personnel.
Nvidia transforme également ce besoin en marché. En 2026, il a introduit OpenShellun environnement d’exécution conçu pour appliquer des contrôles de sécurité indépendants aux agents, ainsi qu’à d’autres composants de la plateforme. Némo. L’entreprise affirme que les limites opérationnelles ne devraient pas dépendre uniquement du comportement du modèle, mais être appliquées par l’infrastructure qui l’héberge.
Le 21 septembre, Nvidia a défini la sécurité de l’IA comme un problème d’ingénierie basé sur le contrôle d’accès, l’isolation, la surveillance et la vérification continue.
L’Europe dispose déjà d’outils pour intervenir
Le débat intervient alors qu’une partie importante de la loi sur l’IA est entrée en phase opérationnelle dans l’Union européenne. Les obligations spécifiques imposées aux fournisseurs de modèles d’IA à usage général sont applicables à partir du 2 août 2025. À partir du 2 août 2026, la Commission peut exercer des pouvoirs coercitifs, y compris des sanctions.
Le cadre européen dispose donc déjà d’outils permettant d’intercepter certains des problèmes soulevés par les chercheurs, notamment lorsque l’automatisation de la recherche affecte les capacités des modèles, la cybersécurité ou les risques de perte de contrôle. Cependant, il n’existe pas de norme internationale commune permettant de mesurer la part de la recherche sur l’IA réellement réalisée par des machines.
Anthropic propose par exemple une échelle qui distingue les systèmes sans implication dans la recherche, les agents qui collaborent avec les humains, les agents qui guident une tâche et les agents totalement autonomes. L’entreprise reconnaît qu’une méthodologie commune serait nécessaire entre les laboratoires et émet l’hypothèse de contrôles confiés à des tiers.
Le nœud politique international
Les auteurs du document publié le 28 septembre appellent également à des accords internationaux réduisant le risque d’une ruée déstabilisatrice vers des systèmes de plus en plus performants. C’est une question qui divise les gouvernements sur le degré de coordination supranationale à accepter.
Aux États-Unis, l’administration Trump suit une ligne différente de celle souhaitée par les auteurs sur le rôle des institutions internationales. Dans son discours devant l’Assemblée générale des Nations Unies le 22 septembre 2026, Trump a déclaré que les États-Unis rejetaient un système mondial de contrôle de l’intelligence artificielle. Cette déclaration reflète la priorité accordée par l’administration à la souveraineté nationale et au leadership technologique américain.
Toutefois, la politique américaine ne coïncide pas avec l’absence de règles. Un mémorandum présidentiel du 5 juin a appelé les installations de sécurité nationale à utiliser des systèmes d’IA avancés tout en respectant les exigences de robustesse, de contrôlabilité et de responsabilité tout au long de la chaîne de commandement.
Le conflit porte principalement sur la question de savoir qui doit fixer les normes et avec quel niveau de coordination internationale.
Les enjeux économiques : qui contrôle le cycle de l’innovation
Pour les entreprises et les investisseurs, l’automatisation de la recherche peut modifier la structure concurrentielle de l’ensemble du secteur. Si un laboratoire peut utiliser ses propres modèles pour concevoir plus rapidement les suivants, il obtient un avantage qui ne dépend pas seulement de l’accès aux meilleurs chercheurs ou aux puces les plus puissantes. La capacité d’innover elle-même devient un produit de l’IA.
Ce mécanisme peut profiter aux entreprises déjà équipées de grands centres de données, de modèles propriétaires, de capitaux et de grandes quantités de données expérimentales. Cela peut également accroître l’importance des fournisseurs d’infrastructures de sécurité, car des agents plus autonomes nécessitent des réseaux isolés, des systèmes d’autorisation, une journalisation des actions et des contrôles indépendants.
Le scénario d’une soudaine « explosion du renseignement » reste une prédiction et non un fait établi. Une enquête universitaire publiée en 2026, basée sur des entretiens avec 25 chercheurs de laboratoires et d’universités l’année précédente, a révélé de grandes différences dans le calendrier et la probabilité d’une accélération récursive. Cependant, vingt personnes interrogées ont cité l’automatisation de la recherche sur l’IA comme l’un des risques les plus pressants, tandis que les chercheurs universitaires ont tendance à être plus sceptiques que les travailleurs des laboratoires pionniers quant aux scénarios de croissance explosive.
La distinction est cruciale. Il existe aujourd’hui des données montrant des agents capables d’accélérer la recherche et des systèmes effectuant une part croissante du travail technique. Cependant, rien ne prouve qu’une IA puisse développer de manière autonome une séquence indéfinie de modèles de plus en plus puissants.
Pour les régulateurs et les entreprises, le problème se pose avant ce point. Si l’automatisation continue de croître, nous devrons savoir qui autorise les expériences, quelles activités restent sous contrôle humain, comment les incidents sont enregistrés et quels seuils déclenchent des audits indépendants.
La concurrence économique pousse les laboratoires à accélérer. Les incidents publiés ces derniers mois montrent pourquoi la capacité à arrêter un système peut devenir aussi importante que le rendre plus puissant.