Google ouvre SynthID pour vérifier si une image, une vidéo ou un audio est une IA ou non, mais le problème est que c’est un placebo
Si les fausses nouvelles constituaient déjà un problème, diffusées principalement via des réseaux comme X ou Facebook, avec l’arrivée de l’IA générative et la possibilité de réaliser des images qui brouillent de plus en plus la frontière entre réalité et artificiel… cela a explosé. C’est pourquoi Google DeepMind a lancé SynthID en 2023, une marque et un outil à usage fermé pour identifier les fausses images. Maintenant, ils ont décidé de l’ouvrir à tout le monde et il est plus performant que jamais.
Le problème c’est qu’il est (très) loin d’être infaillible.
SynthID. Il s’agit en fait de la technologie de filigrane lancée par DeepMind il y a plusieurs années, et il s’agit essentiellement de quelque chose qui intègre une marque imperceptible dans des images, des vidéos, de l’audio ou du texte généré par l’IA. Il le fait au moment de la création de la pièce et ce n’est pas quelque chose que nous voyons (comme un filigrane dans le texte ou le symbole Gémeaux qui a été précédemment introduit dans l’IA de Google), mais quelque chose de plus profond conçu pour résister aux coupures et aux filtres supérieurs dans le cas des images, aux changements de cadre et à la compression avec perte dans la vidéo ou le bruit, à la compression agressive et aux changements de vitesse dans le cas de l’audio.
Selon Google, avec cette technologie, ils ont marqué plus de 180 000 millions d’images et de vidéos… et plus de 240 000 ans d’audio. C’est tellement fou d’avoir marqué ça et d’avoir généré autant en si peu de temps.
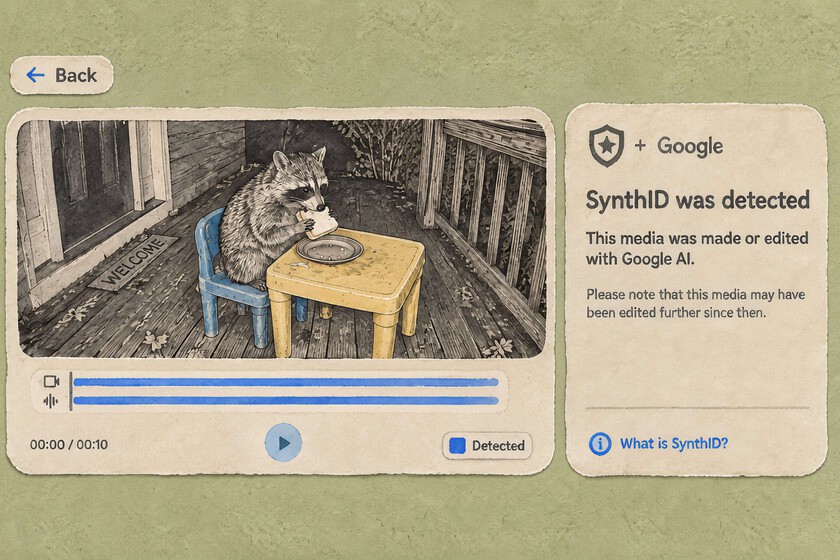
Vous pouvez essayer. C’est aussi simple que d’aller sur le site officiel du service ou sur Gemini et de télécharger un fichier. En quelques secondes, il vous donne un résultat et vous indique avec quoi il a été créé puisque OpenAI et Google ont leur propre tableau de bord. Il existe des limites sur la taille des fichiers, la durée de la vidéo (elles doivent être inférieures à 90 secondes) et il n’y a en réalité que 20 requêtes par jour. Au final, c’est quand même une IA et qui consomme des ressources que Google ne va pas nous donner.
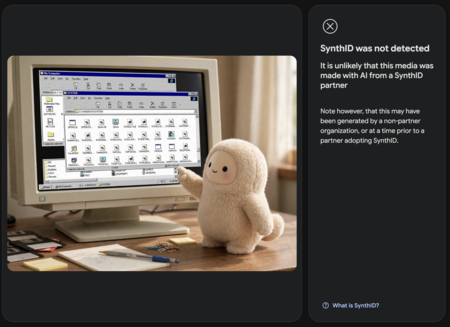
Problème. Ce n’est pas une norme. Les outils Kakao, Nvidia on Cosmos et OpenAI comme ChatGPT ou Codex le prennent en charge et l’intègrent dans leur API, mais si le contenu est généré avec un autre programme d’IA, SynthID ne peut pas lire ces marqueurs cachés et, par conséquent, ne sait pas s’il s’agit d’IA ou non.
J’ai fait le test avec l’image que vous avez juste au dessus de ces lignes, qui est une IA reconnaissable à des kilomètres… et rien. C’est une image qu’un employé de Meta Superintelligence Labs a partagée et qui sait avec quoi il l’a créée, mais soi-disant ni avec Gemini ni avec ChatGPT. Google lui-même souligne que le détecteur ne peut savoir si quelque chose est de l’IA que s’il a été créé « avec l’IA de Google ou de nos partenaires ».
En parlant de Meta, déjà en 2024, l’entreprise de Zuckerberg soulignait qu’il n’était pas possible d’identifier tout le contenu généré par l’IA et que si des outils émergeaient pour l’identifier, d’autres semblaient éliminer les marqueurs. OpenAI dispose de son propre outil basé sur celui de Google et ils reconnaissent eux-mêmes que « le contenu aurait pu encore être généré par OpenAI si ses métadonnées avaient été supprimées ou manipulées, si son filigrane était dégradé, s’il provenait d’un modèle de génération hérité ou s’il avait été créé avant que les signaux de provenance n’existent ».
Alternatives. Les entreprises qui créent l’IA et la perfectionnent pour la rendre de plus en plus précise, allant même jusqu’à effacer les filigranes auparavant clairement visibles, sont les mêmes qui travaillent sur des outils permettant d’identifier ces fausses images. Cela ajoute une complication à quelque chose qui devrait être beaucoup plus simple, mais outre SynthID, Adobe et Meta ont également lancé des systèmes similaires.
La proposition la plus notable en ce sens est la norme C2PA (Coalition for Content Provenance and Authenticity). Celui-ci gère des technologies telles que la spécification Content Credentials pour étiqueter le contenu généré par l’IA et certaines des plus grandes entreprises du secteur sont incluses. L’autre alternative est la plus utopique : la confiance en l’humanité.
En mars 2025, le gouvernement a approuvé un projet de loi qui considère le fait de ne pas étiqueter le contenu généré par l’IA comme une violation grave. Depuis lors, non seulement nous avons été bombardés d’éléments générés par l’IA, mais même de faux influenceurs (créés avec l’IA, je veux dire) ont publié des messages nuisibles sur n’importe quoi et avec un message qui peut trouver un écho auprès de certains publics.
À Simseo | On pourrait supposer que le monde végétal était l’un des derniers coins sans IA. nous aurions tort