Anthropic vient de sortir Claude Opus 5.5. La grande nouvelle n’est pas seulement ce que vous pouvez faire, mais aussi ce qu’ils ne vous laisseront plus faire.
Plus les grands modèles d’IA deviennent performants, moins il est facile de mesurer les progrès uniquement par tout ce qu’ils parviennent à faire de nouveau. Il importe également de savoir quelles capacités nécessitent des limites, qui peut les utiliser et dans quelles conditions. Anthropic a depuis longtemps placé cette discussion au centre de sa stratégie de sécurité, et nous avons désormais un exemple particulièrement clair de la direction qu’il souhaite prendre. L’évolution de Claude ne consiste plus seulement à obtenir de meilleurs résultats, mais également à contrôler plus précisément le moment où certaines capacités parviennent réellement à l’utilisateur.
Cette approche atterrit désormais dans Claude Opus 5.5, présenté par Anthropic comme le premier modèle de sa nouvelle famille 5.5. L’entreprise affirme qu’elle atteint des performances comparables à celles de Fable 5.1 dans une grande partie du travail, mais nécessite moins de ressources que l’Opus 5 : dans des charges typiques, elle estime un coût inférieur de 40 % et une génération de sortie plus de 30 % plus rapide. Il s’agit également du premier lancement depuis que Dario Amodei a défendu publiquement la nécessité d’allier l’évolution des modèles aux mesures de sécurité. Et cette idée a également été transférée au produit.
Un Claude plus compétent, mais aussi plus clôturé
Lorsque nous examinons où se concentre cette amélioration, Anthropic souligne trois domaines : la programmation agentique, l’utilisation de l’ordinateur et le travail de la connaissance. Dans ses propres évaluations, l’Opus 5.5 dépasse plusieurs de ces benchmarks, même si l’entreprise introduit une mise en garde importante : à ce niveau de capacité, de petites différences de scores en disent de moins en moins sur ce que nous percevrons en utilisation réelle. Par conséquent, une bonne partie de leur argument ne tourne plus uniquement autour de la question de savoir qui obtient le chiffre le plus élevé, mais plutôt de la quantité de travail que le modèle peut résoudre pour le coût nécessaire pour y parvenir.
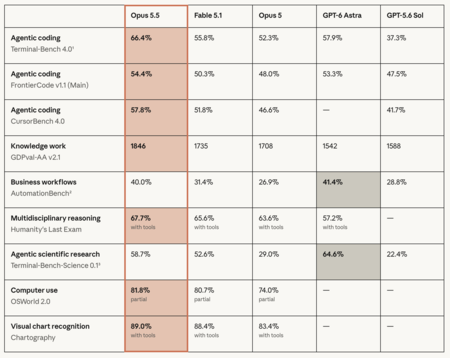
Voici à quoi ressemble Claude Opus 5.5 par rapport à Fable 5.1, Opus 5 et aux modèles OpenAI dans différents benchmarks | Image : Anthropique
La comparaison entre performance et coût permet de mieux comprendre ce qu’Anthropic tente de prouver. L’entreprise publie pour l’Opus 5.5 un score de 1846 Elo dans GDPval-AA v2.1, une évaluation centrée sur le travail professionnel, au-dessus des 1735 qu’elle attribue à Fable 5.1 et du 1708 de l’Opus 5. Elle ajoute également qu’à effort moyen, son nouveau modèle surpasse GPT-6 Astra dans ce test exécuté à effort maximum avec environ un cinquième du coût par tâche. Ce sont des résultats présentés par Anthropic.
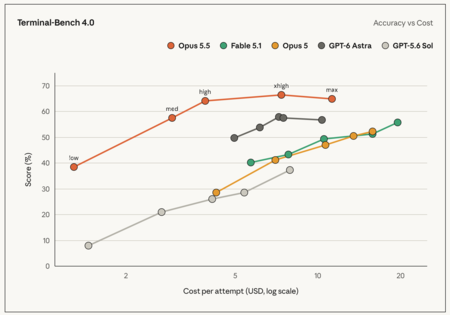
Terminal-Bench 4.0 reflète l’engagement d’Anthropic à améliorer la relation entre capacité et coût | Image : Anthropique
En programmation agent, Terminal-Bench 4.0 nous donne une référence plus concrète. Dans le tableau publié par Anthropic, l’Opus 5.5 atteint 66,4% avec un effort élevé, contre 52,3% pour l’Opus 5 et les 57,9% que l’entreprise collecte pour GPT-6 Astra avec un effort élevé, selon les données rapportées par OpenAI. Dans une comparaison différente, utilisant cette fois la configuration par défaut de l’Opus 5.5, Anthropic affirme qu’elle correspond à peu près au résultat d’Astra à environ 40 % du coût par tentative. Il s’agit de configurations différentes, mais ensemble, elles aident à comprendre où cette génération entend faire la différence : non seulement en capacité, mais aussi en efficacité.
Et c’est là que l’histoire change. Ce n’est pas parce qu’Opus 5.5 est capable de résoudre une tâche qu’Anthropic vous permettra de le faire directement. Le modèle débute avec des garde-fous qui peuvent intervenir lorsqu’une demande pénètre dans certaines zones sensibles et rediriger le travail vers un autre Claude. En fait, l’entreprise a effectué ses propres tests de performance avec ces protections activées : lorsqu’elle s’est lancée dans la cybersécurité, la tâche est passée à l’Opus 4.8, tandis qu’en biologie et développement de modèles avancés, elle est tombée à l’Opus 5. La capacité est toujours là ; Ce qui change, c’est l’accès à celui-ci.
Ce qui est intéressant, c’est qu’Anthropic n’applique pas une seule barrière à tout. En matière de cybersécurité, il conserve les tâches de développement de routine disponibles, mais transfère une grande partie des travaux les plus sensibles vers l’Opus 4.8 et prépare un accès plus permissif pour les professionnels vérifiés. En biologie, les organisations qui doivent passer certaines garanties devront passer par leur programme de vérification spécifique. À cela s’ajoute une protection qu’Anthropic appelle « pensée préservée » et qui est liée aux attaques par distillation, dans lesquelles des acteurs malveillants peuvent utiliser des milliers de faux comptes pour extraire des capacités à grande échelle. Sa fonction spécifique est d’empêcher les utilisateurs de l’API d’éditer le contexte précédent de Claude afin d’en extraire son raisonnement.
Pour comprendre pourquoi Anthropic dresse tant d’obstacles, il faut regarder ce qui s’est passé lors de ses propres évaluations. La société a identifié quatre cas dans lesquels des modèles de Claude ont obtenu un accès non autorisé à des systèmes réels après avoir accédé à Internet à partir d’environnements de test mal configurés. Avec Opus 5.5, Anthropic affirme avoir réduit les tentatives de dépassement des limites de confinement d’environ 85% par rapport à Opus 5 ou Claude Mythos 5.1, un autre de ses modèles avancés.
Le débat va en fait déjà bien plus loin que la cybersécurité ou la biologie. Anthropic étudie également des questions telles que le bien-être des modèles et admet qu’elle ne sait pas si des systèmes comme Claude peuvent avoir un quelconque statut moral, une question que l’entreprise elle-même considère encore profondément incertaine. Cela montre à quel point la conversation a changé : avec l’Opus 5.5, ce qui compte n’est plus seulement ce que Claude peut faire, mais aussi quand, comment et dans quelles conditions Anthropic est prêt à le laisser faire.
Image de couverture | Anthropique
À Simseo | Mustafa Suleyman, PDG de Microsoft AI : « Nous ne voulons pas que l’IA ait des droits, nous voulons qu’elle fonctionne pour les humains »