Pangram est-il l’arbitre de l’IA dont l’industrie littéraire a besoin ? Un auteur péruvien le découvre dans sa chair
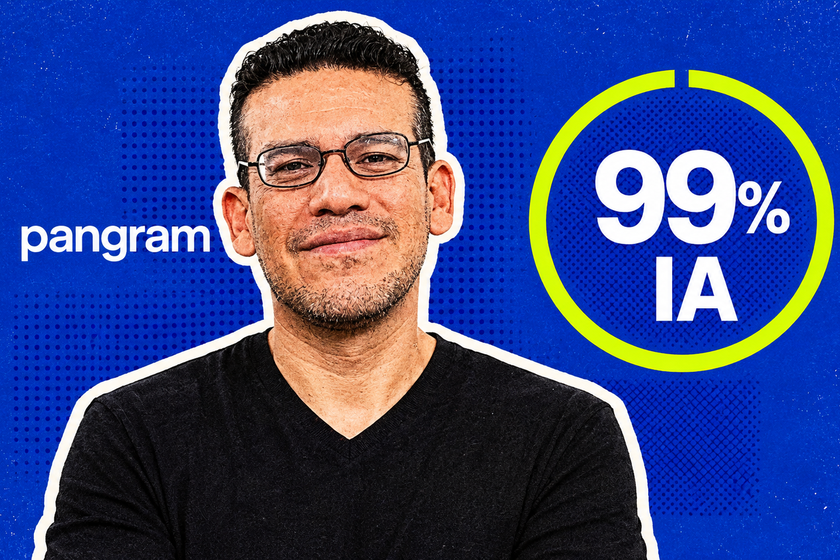
Le 23 octobre, El País a publié que le détecteur Pangram attribue 99 % de « Où fonctionne l’eau » à l’IA, lauréate d’un prix dont les bases interdisaient l’utilisation de l’IA. L’auteur nie cela et l’éditeur a suspendu les soumissions le temps d’examiner le cas. À l’instar de l’œuvre de Thélyson Orélien « C’était ça ou mourir », le roman de David Silva Roja s’intéresse à l’exploitation, à la douleur et à la mémoire. Il a été choisi parmi 2 204 manuscrits provenant de 22 pays pour « la subtilité de son écriture et l’utilisation magistrale des silences comme ressource compositionnelle ».
En tout cas, il a remporté les 20 000 euros auxquels aspirait le Prix international du roman court Almadía-Ventosa Arrufat et est déjà en cours de traduction. Et plusieurs de ses présentations ont également été annulées. Bien entendu, nous n’allons pas décider ici si le roman est ou non le résultat de l’IA. Car, en réalité, c’est difficile à valoriser. L’enjeu est autre : en quelques mois, le programme d’une entreprise privée est devenu de facto un juge de la paternité littéraire. Pangram est-il l’arbitre dont nous avons besoin ?
Ce qu’il fait et ce qu’il fait bien
Pangram est un classificateur de réseaux neuronaux formé sur du texte humain et du texte généré par un modèle, avec des techniques pour réduire les faux positifs. Il évalue par morceaux et renvoie un pourcentage : une estimation de la façon dont un texte ressemble à ce qu’une machine taperait, et non une reconstruction de la façon dont il a été écrit.
Selon l’entreprise elle-même, Pangram 4 détecte 99,66 % des textes IA et signale 0,0041 % d’erreurs humaines, soit une erreur pour 24 000 documents. Et ce n’est pas seulement l’entreprise qui le dit : une étude de l’Université de Chicago l’a placé au-dessus de GPTZero et Originality.ai, et El País a constaté qu’il donnait 0 % dans les livres avant ChatGPT. Dans l’affaire Goncourt, il a été confirmé par la suite que l’auteur avait utilisé l’IA.
La version utilisée par El País, Pangram 4.1, a été publiée le 19 octobre, quatre jours avant la publication de l’analyse. Sur 29 103 paires de textes avec des modifications minimes, les changements de verdict indésirables chutent de 1,08% à 0,15%, un problème similaire à celui souligné par les expériences d’ajout d’une virgule ou d’un espace supplémentaire (nous en avons déjà parlé ici). De plus, il renvoie la probabilité de chaque étiquette (humaine, assistée par l’IA ou générée par l’IA) et montre moins de certitude dans les textes de moins de 150 mots.
La société estime ses faux positifs à 0,009 % en anglais et à 0,0026 % en espagnol, mais elle les mesure sur des textes Web et non sur des romans. Les faux négatifs augmentent légèrement, passant de 0,34 % à 0,37 %. Et le listing lui-même admet que son taux d’erreur n’est pas nul et qu’une simple erreur peut nuire à la réputation.
Ce qu’il ne fait pas bien
Nature rapporte que, lorsqu’une IA modifie considérablement les essais sur des humains, Pangram les qualifie d’humains dans 41 % des cas. Le tromper n’est pas difficile : Jot Down a également montré comment un espace supplémentaire change le verdict. Une récente prépublication affirme qu’après passage dans un « humaniseur », les faux négatifs dépassent les 96 %, tout le contraire de ce qu’annonce l’entreprise (98,83 % de détection par rapport à 13 humaniseurs). Les études ne sont jamais d’accord.
Il existe une limite plus subtile. Son PDG explique que le taux de faux positifs se mesure avec des millions de textes antérieurs à 2022. En attendant, on soupçonne que de nombreux écrivains auront appris à introduire l’IA dans leurs articles et à mieux la cacher. Dans l’ensemble, c’est un bon test pour les débutants, mais il ne vous dit pas comment vous noterez un écrivain en 2026, après des années de lecture et de correction avec des modèles. Et un pourcentage ne révèle pas qui a fait quoi : si l’IA a rédigé, corrigé ou simplement suggéré des intrigues. De plus, l’erreur n’est pas symétrique, comme nous l’avons déjà dit : un faux positif peut détruire une réputation et un faux négatif ne coûte rien.
Arbitre avec intérêt commercial
Pangram Labs est une entreprise fondée par deux collègues de Brooklyn, et son activité se développe avec méfiance : selon The Decoder, qui cite le New York Times, son chiffre d’affaires a été multiplié par 35 en un an et ses utilisateurs mensuels sont passés de 2 700 à 120 000 entre juin 2025 et juin 2026. Les taux d’erreur les plus cités sont les leurs. À mesure que votre « intervalle de confiance » diminue, votre succès semble augmenter. Mais comme l’a indiqué Tim Requarth, aucun de ses modèles n’est aujourd’hui capable de comprendre les couches et les couches que traverse un texte réel.
L’étude de Chicago est indépendante (elle est financée par l’université et un programme Google Cloud, et non par Pangram), mais GPTZero affirme que, avec ce même benchmark, elle surpasse désormais Pangram. Il n’y a pas de standard : chaque fournisseur choisit la métrique, le seuil et le corpus. Et il n’y a pas non plus de protocole. L’affaire Goncourt a commencé avec un compte anonyme sur X qui a transmis des fragments via Pangram. L’Académie a demandé à la prudence et à vérifier la fiabilité du logiciel. Aujourd’hui, n’importe qui peut ouvrir un dossier sans seuil défini ni droit de réponse, au milieu du bruit de la « foutue IA ».
Et s’il y avait un procès ?
À ce jour, il n’existe aucune décision espagnole sur la valeur probante de ces détecteurs. Dans une procédure pénale, la recevabilité dépend de la pertinence et le juge évalue librement les éléments de preuve. Un rapport Pangram devrait être présenté comme une opinion d’expert, avec un expert capable d’expliquer la méthode, la marge d’erreur, et de se soumettre à un contre-interrogatoire.
Seulement là, nous avons trois problèmes. C’est une boîte noire neurale qui n’explique pas pourquoi elle marque une phrase ; le taux d’erreur est déclaré par le fabricant ; et leurs modèles changent (Pangram 3 avait une date de retrait au 30 septembre), ce qui rend difficile la reproduction d’un verdict des mois plus tard. Très probablement, cela servira d’indication pour demander des traites, et non de preuve de poursuites en soi.
Qu’exigerions-nous d’un arbitre ?
Si nous avons besoin d’un juge de ce qu’est l’IA, elle doit être fiable, auditée, juridiquement valable et neutre. Pangram est aujourd’hui, et de loin, le détecteur le mieux noté. Pourtant, c’est loin d’être infaillible. Leurs audits appartiennent au domaine académique, ils ne sont pas appuyés par des audits publics et récurrents avec accès au modèle. Aucune norme ne reconnaît sa validité juridique et il existe un conflit d’intérêt puisque c’est l’entreprise elle-même qui défend son outil.
L’Europe avance en revanche. L’article 50 de la loi sur l’IA oblige les fournisseurs d’IA générative à marquer leurs résultats dans un format lisible par machine (avec une date limite du 2 décembre 2026 pour les systèmes déjà sur le marché), et la Commission a publié un code de bonnes pratiques le 10 juin. Mais un filigrane ne prouve rien à lui seul et ne couvre pas les modèles ouverts ou les textes réécrits. Il manque un auditeur indépendant, public et européen pour mesurer ces détecteurs avec des tests ouverts et comparables. Ce que nous avons n’est même pas proche de cela.
Images | Configuration créée à l’aide de ChatGPT
À Simseo | Pangram voit 99 % d’IA dans le roman primé « Where Water Works ». Le problème est toujours le même : il n’existe pas de détecteur infaillible