Une entreprise affirme avoir créé un modèle d’IA capable de passer le test de Turing. Nvidia pense différemment
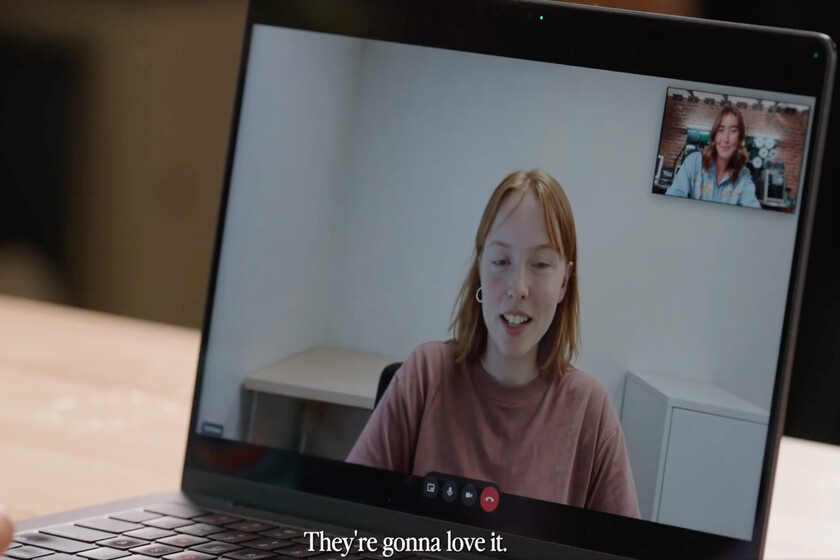
Un appel vidéo a quelque chose que nous tenons presque pour acquis depuis longtemps : si nous voyons quelqu’un réagir à ce que nous disons, nous interrompre, sourire au bon moment ou regarder ce que nous venons de montrer à la caméra, nous supposons qu’il y a une personne de l’autre côté. L’intelligence artificielle complique cette certitude depuis des années avec des voix clonées et des vidéos synthétiques, mais maintenir toutes ces interactions en direct est une autre histoire. Et c’est précisément là que vient d’apparaître un modèle visant à gommer une bonne partie de cette distance.
Ce modèle s’appelle Griffin, bien que la version que Tavus a soumise à ces tests soit Griffin-Lite, une version de recherche préliminaire. Son résultat le plus frappant vient d’une expérience réalisée auprès de 54 participants : après avoir discuté une minute avec le système, 26 d’entre eux, soit 48%, ont déclaré croire que leur interlocuteur avait été une personne réelle. L’entreprise affirme que ce résultat fait de Griffin le premier modèle capable de passer un « test vidéo de Turing » en temps réel. La déclaration nécessite cependant un peu de contexte.
Ce que signifie vraiment réussir un test de Turing en vidéo
La clé réside dans la façon dont l’expérience a été mise en place. Les 54 participants, recrutés via une plateforme de recherche indépendante, pensaient qu’ils allaient discuter une minute avec une autre personne de ce qu’ils attendaient avec impatience cette année. De l’autre côté se trouvait Griffin-Lite, générant la conversation et la présence audiovisuelle en direct. On ne leur a pas demandé dès le début de faire la distinction entre l’humain et l’IA : cette question n’est apparue qu’à la fin, après avoir évalué des aspects tels que le naturel, la confiance et la fluidité. Sur les 54, 26 ont déclaré croire que leur interlocuteur était réel ; Lors d’un test équivalent avec le système précédent de l’entreprise, seulement 1 personne sur 41 a répondu la même chose. Le recrutement a été réalisé via une plateforme indépendante, mais le test et ses résultats ont été publiés par Tavus elle-même.
Ici apparaît la première grande nuance. L’approche publiée par Alan Turing en 1950, dont est dérivé le test qui porte aujourd’hui son nom, n’incluait pas de visages, de voix ou d’appels vidéo : la communication devait se faire par écrit, précisément pour qu’aucun indice physique ne conditionne la décision de l’interrogateur. Il n’existe pas non plus de protocole unique reconnu qui fonctionne comme « le » test de Turing vidéo. Le terme avait déjà été utilisé dans la recherche avant Griffin : en 2023 par exemple, un ouvrage publié dans AI Magazine présentait sous ce nom un test visant à évaluer dans quelle mesure une IA pouvait comprendre les vidéos d’une manière comparable à un humain. Tavus applique l’idée d’indiscernabilité à une expérience différente, basée sur une conversation audiovisuelle en face à face.
Il existe également un précédent très récent pour un test de Turing à trois participants. Une étude publiée dans PNAS en mai 2026 a permis à chaque interrogateur de converser pendant cinq minutes, par écrit et simultanément, avec une personne et un modèle avant de décider lequel des deux était humain. GPT-4.5, lorsqu’on lui a donné des instructions supplémentaires pour adopter une personnalité humaine, a été choisi comme personnage dans 73 % des cas. Avec le même modèle dans un état sans ce bloc d’instructions de personnalité, le chiffre est resté à 36 %. Les résultats ne sont pas directement comparables à ceux de Griffin car les protocoles sont différents : la nouveauté dont revendique Tavus est de transférer cette confusion à une interaction audiovisuelle en direct.
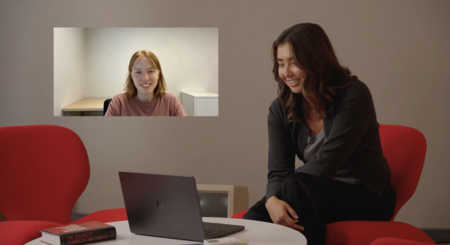
Griffin-Lite maintient des conversations audiovisuelles en temps réel et génère des visages, des voix et des réponses à la volée | Image : Tavus
La différence réside dans le fonctionnement de Griffin-Lite. Le système n’attend pas simplement que nous ayons fini de parler pour commencer à réagir, mais a été conçu comme un modèle : tout en générant de la voix et de la vidéo, il continue d’écouter et d’observer et réévalue la conversation à des intervalles inférieurs à une seconde. Cela nous permet de hocher la tête pendant que nous parlons, d’interpréter une pause sans la confondre automatiquement avec la fin de notre tour, de nous laisser interrompre ou de réagir à quelque chose que nous montrons devant la caméra. La voix, le visage, le regard et les gestes sont également générés à partir des mêmes décisions conversationnelles.
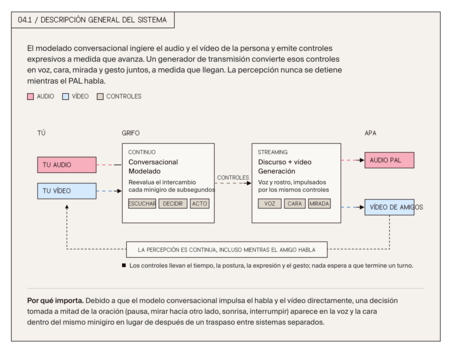
C’est ainsi que fonctionne l’architecture conversationnelle full-duplex de Griffin-Lite, selon Tavus (le graphique original en anglais a été traduit en espagnol) | Image : Tavus
Nous disposons cependant d’une référence externe pour vérifier ces capacités. NVIDIA inclut Griffin-Lite dans VideoFDB, un benchmark basé sur 237 fragments d’appels vidéo réels et 11 dynamiques de conversation. Ses rubriques sont notées de 0 à 5 par un juge basé sur un modèle de langage, et Griffin-Lite est actuellement en tête des tableaux publiés pour la perception, avec 3,73 contre 4,20 pour la référence humaine, et la génération, avec 3,83 contre 3,92. NVIDIA souligne cependant que les systèmes évalués restent en deçà de la référence humaine en termes de naturel conversationnel.
Tout cela ne signifie pas non plus que nous pouvons aller à Tavus aujourd’hui et demander à Griffin de répondre à nos appels vidéo. L’entreprise commercialise déjà une plateforme permettant de créer des PAL, des agents audiovisuels qui peuvent être intégrés dans des produits via des API, construits sans code avec PAL Maker ou développés sous forme de solutions commerciales personnalisées. Il les guide vers des usages tels que la vente, la formation ou le service client. Griffin-Lite occupe pour l’instant une autre place : il s’agit encore d’une version de recherche disponible uniquement à un groupe de testeurs sélectionnés et Tavus ne la propose pas encore à ses clients. La société assure qu’une version plus puissante de Griffin arrivera plus tard.
Et voilà qu’apparaît l’autre aspect de la création d’une IA si convaincante. Tavus reconnaît que les mêmes fonctionnalités qui permettent une interaction plus naturelle peuvent également amener quelqu’un à croire qu’il ne parle pas à une IA, et affirme travailler sur des fonctionnalités d’avertissement pour répondre à ce risque avant d’étendre la version. Sa politique actuelle exige un consentement explicite et éclairé pour créer une réplique avec l’image ou la voix d’une personne et exige un signalement clair lorsqu’une personne interagit avec du contenu généré ou un agent IA. Dans l’UE, par ailleurs, la loi sur l’IA exige depuis le 2 août 2026 que les systèmes conçus pour interagir directement avec les personnes les informent qu’elles parlent à une IA, sauf lorsque cela est évident compte tenu des circonstances.
Images | Tavus
À Simseo | La loi de Moore n’est pas à la hauteur : le coût de l’IA diminue six fois plus vite que celui de l’informatique classique