IBM affiche des chiffres qui défient les géants fermés de l’IA : 90 % des performances pour seulement 10 % du coût par token
La course à l’intelligence artificielle tourne depuis longtemps autour d’une seule question : qui possède le modèle le plus performant. Chaque nouvelle génération cherche à résoudre des tâches plus complexes, alors que les comparaisons tendent à se porter vers le haut du classement. Mais il y a une autre question qui commence à devenir importante lorsque nous cessons d’essayer ces outils par curiosité et que nous devons réellement les utiliser : combien cela nous coûte-t-il pour obtenir une réponse suffisamment bonne. La différence peut sembler minime, jusqu’à ce que l’on imagine cette même requête répétée des milliers ou des millions de fois.
Ce choix comporte plus de voies que celles suggérées par les applications d’intelligence artificielle que nous utilisons quotidiennement. Nous pouvons accéder à ces outils via des services gratuits, des abonnements payants ou des fournisseurs payants en fonction de l’utilisation, mais il existe également des modèles de poids ouverts qui peuvent être exécutés sur notre propre infrastructure ou par l’intermédiaire de tiers. Pour une entreprise, cela ouvre des possibilités qui vont au-delà de la location du service le plus avancé du marché.
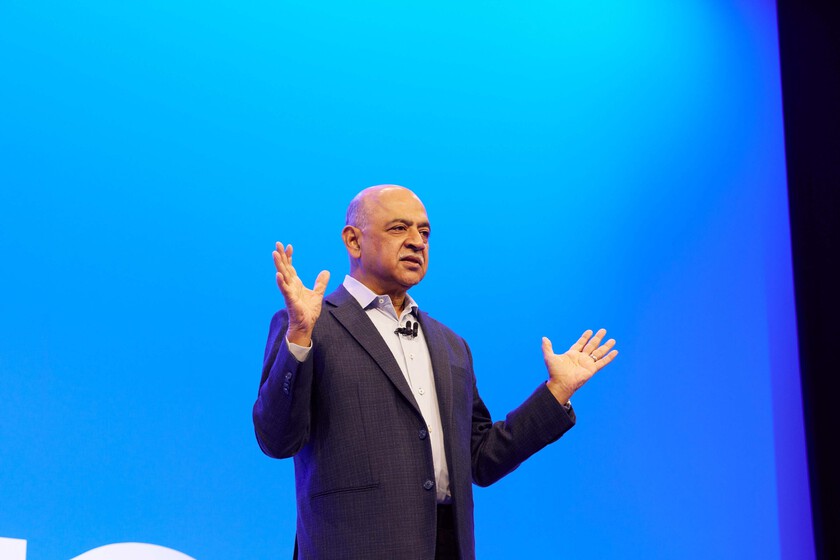
La discussion a abouti à la présentation des résultats financiers d’IBM. Lors de la période des questions, Matt Swanson, analyste chez RBC Marchés des Capitaux, voulait savoir comment les grandes entreprises conciliaient deux exigences qui peuvent entrer en tension : contenir les dépenses en intelligence artificielle et garder le contrôle sur son déploiement. Arvind Krishna, PDG d’IBM, a répondu en remontant à fin 2024 et en comparant l’évolution des modèles les plus avancés avec celle des alternatives de poids ouvertes. Son argument met en évidence un changement qui, selon lui, modifie ce choix.
L’intelligence artificielle a une nouvelle bataille et elle ne se livre pas seulement en termes de performance
Pour comprendre l’ampleur du changement décrit par l’exécutif, il convient de regarder les chiffres qu’il a utilisés. Fin 2024, il évoquait l’exemple d’un modèle frontière qui pourrait obtenir 70 points dans une évaluation large, contre 20 ou 30 pour une alternative ouverte. « C’est un écart trop grand. Personne ne va l’accepter », a-t-il déclaré. D’ici fin 2025, selon son exemple, la différence aurait été réduite à 70 contre 50. Il estime désormais que les modèles à poids ouvert atteignent environ 90 % de l’efficacité des plus avancés et un coût par token entre 10 % et 25 % de ce que coûtent ces derniers. Ce sont des évaluations de Krishna, qui n’a pas identifié de preuves concrètes pour les contraster.
Il convient de s’arrêter à une expression qui apparaît tout au long de cette comparaison : les modèles à poids ouverts. Les « poids » sont les paramètres numériques qu’un système d’intelligence artificielle apprend et ajuste au cours de sa formation, et qu’il utilise ensuite pour traiter les informations et générer des réponses. Lorsqu’une entreprise les publie, d’autres peuvent les télécharger et exécuter le modèle sur leurs propres ordinateurs, toujours dans les conditions de leur licence. Cela ne signifie pas que nous savons comment vous vous êtes formé ou que nous avons accès à toutes vos données et outils. Par conséquent, comme l’explique l’Open Source Initiative, disposer des pondérations n’équivaut pas nécessairement à avoir un modèle open source.
Les économies dont parle Krishna sont mieux comprises en examinant la manière dont ces systèmes sont facturés pour leur utilisation. Un jeton est une unité avec laquelle le modèle représente des fragments du texte qu’il reçoit ou génère, et de nombreux fournisseurs facturent en fonction de la quantité traitée. « Préférez-vous quelque chose qui coûte 10 % s’il atteint 90 % des performances des meilleurs, ou voulez-vous payer un coût dix fois plus élevé ? » » a déclaré l’exécutif. D’après les calculs d’IBM, une grande entreprise moyenne pourrait commencer avec deux ou trois racks, des armoires abritant des serveurs et d’autres équipements, pour exécuter ces alternatives. Mais cette infrastructure nécessite des investissements, de l’électricité, de la maintenance et du personnel spécialisé. Les économies réelles dépendent du volume d’utilisation, au point que l’embauche d’une API peut encore s’avérer moins coûteuse pour les petites charges de travail.
Après les coûts vient une question inévitable : quels emplois ont réellement besoin du modèle le plus avancé ? Krishna admet que certains le font, mais estime que de nombreuses tâches commerciales peuvent être résolues avec des options moins coûteuses. Il a cité des exemples quotidiens, depuis la synthèse d’un e-mail et la rédaction d’un autre jusqu’à l’examen d’un contrat ou la prise d’un appel d’un client. « Tout cela peut tout aussi bien être fait avec l’alternative beaucoup moins chère », a-t-il déclaré. Il s’agit de votre évaluation de ces utilisations, et non d’une garantie qu’un système offre des résultats équivalents dans tous les cas. Le choix dépend également de la complexité de chaque tâche et de la fiabilité dont nous avons besoin.
Les affirmations d’IBM ne sont pas isolées. En mai 2026, l’Organisation de coopération et de développement économiques (OCDE) a publié un rapport, basé sur des données antérieures, qui plaçait les modèles de pondération ouverts à environ 90 % de l’indice de qualité des alternatives fermées une fois arrivés sur le marché, mais avec un prix équivalent à 20 % dans les services cloud. Il y a des nuances importantes : l’AI Index 2026 de Stanford souligne qu’en mars, le meilleur modèle fermé a dépassé de 3,3% le score des meilleurs poids ouverts d’Arena, un classement basé sur une analyse comparative des utilisateurs. Il s’agit de mesures différentes et aucune n’établit une équivalence universelle des capacités.
Il convient de garder à l’esprit qui fait cette comparaison. IBM développe sa propre famille de modèles Granite et travaille sur des technologies pour faciliter le déploiement de l’intelligence artificielle, bien qu’il entretienne également une alliance avec OpenAI. Elle a donc des intérêts commerciaux sur ce marché, mais le débat qu’elle suscite dépasse ses propres produits. Si une entreprise peut résoudre une bonne partie de ses besoins avec des alternatives moins coûteuses, toujours utiliser le système le plus avancé n’est plus une décision aussi évidente. La question est de trouver le bon équilibre entre capacités, coûts et contrôle, sans compromettre la qualité des résultats.
Images | IBM
À Simseo | L’Allemagne met en difficulté le mode IA de Google : lorsqu’il n’y a pas de liens dans le résumé, l’opinion est celle de Google