GPT-6 Astra à l’épreuve : temps réel sur trois tests pratiques
On ne peut pas juger un simulateur en le regardant. Il est jugé en prenant les nombres qu’il produit et en les vérifiant à l’extérieur, avec une calculatrice et une loi de la physique qui ne dépend pas de celui qui a écrit le code.
C’est ce que nous avons fait le 16 septembre, en ouvrant une session de GPT-6 Astra au niveau d’effort Max et en lui confiant deux tâches d’affilée, plus deux changements ultérieurs sur la seconde. Cela ne nous intéressait pas de savoir si cela produisait quelque chose de beau, tous les modèles faisaient ça depuis un an. Nous voulions savoir si cela produisait quelque chose de bien, et surtout ce qui se passait lorsque je lui demandais de changer quelque chose qui fonctionnait déjà.
Trois requêtes, un chronomètre et une calculatrice
Un simulateur d’orbite interactif dans un fichier HTML autonome, avec des curseurs et un panneau de mesure. Un jeu jouable dans le navigateur, genre au choix. Ensuite, sur le jeu, deux changements : un fonctionnel qui affecte plusieurs couches du logiciel, un chirurgical qui ne déplace qu’un seul paramètre.
Nous avons chronométré l’horloge, noté les heures déclarées par l’interface et vérifié les résultats en dehors de l’instrument lorsque cela était possible. Un avertissement pratique pour ceux qui souhaitent refaire le test : à partir de l’écran vide, ChatGPT rattache une référence à la génération d’image en haut du champ de texte, et si elle y reste il redirige la requête. Je l’ai enlevé avant l’envoi.
Ce que nous n’avons pas vérifié, j’écrirai où cela se produit, car un test sans le périmètre déclaré ne vaut pas grand-chose. Une seule tentative par tâche, pas de répétition systématique, pas de comparaison avec d’autres modèles sur les mêmes requêtes.
Le simulateur m’a dit comment le réfuter
La première demande concernait un simulateur avec un corps central et trois planètes, une gravité newtonienne intégrée numériquement, des curseurs sur la masse initiale, la distance et la vitesse, des traces orbitales et un panneau affichant le rayon moyen et la période mesurée en temps réel. J’ai précisé la raison : Je veux lire ces chiffres et vérifier par moi-même la troisième loi de Kepler.
Vingt secondes après l’envoi, Astra a déclaré ce qu’elle utiliserait, la compétence d’affichage pour l’interface et la compétence de fichier pour la livraison. Au bout de cinquante secondes, un programme en trois points avait été construit, et le troisième consistait à vérifier la physique et les interactions avant de livrer. Ensuite, la ligne d’état est passée à la vérification de l’environnement et du runtime disponibles.
Nous avons travaillé seize minutes et neuf secondes. Le résultat s’exécute hors ligne, avec sept curseurs, pause, avance d’une année à la fois, rythme réglable, pistes et un bouton pour exporter les mesures au format CSV. À côté de chaque planète se trouvent la vitesse circulaire et la vitesse de fuite calculées pour cette distance, et dans l’en-tête, il a écrit « Orbites mesurées », ce qui est une déclaration d’intention plus honnête que de nombreuses démos.
Dans la livraison, il nous a également expliqué comment le tester : attendre un tour complet pour lire la période, et comparer la relation entre le carré de la période et le cube du demi-axe, en rappelant que dans les ellipses il faut le demi-grand axe, qui en fait apparaît à côté du rayon moyen. Il m’a tendu l’outil pour le falsifier, ce qu’un artefact construit pour impressionner ne fait presque jamais.
Le panel, qu’il a appelé banc de mesure, rapporte de nouveaux résultats à chaque tour effectué. Lors du premier essai, il donnait toujours des valeurs brutes, les planètes extérieures n’étant pas disponibles car elles n’avaient pas fermé leur orbite. Après quelques dizaines de tours, les nombres s’étaient stabilisés : planète A avec demi-axe 0,89998 unités astronomiques et période 0,85378 années, planète B avec 1,50005 et 1,83722, planète C avec 2,30004 et 3,48822.
Je les ai pris et je les ai recomptés dehors. Le rapport entre le carré de la période et le cube du demi-axe, qui selon la troisième loi de Kepler doit être un, est de 0,999985, 1,000012 et 1,000004. Des écarts de l’ordre du cent millième sur une plage de rayons allant de neuf dixièmes à 2,3 unités astronomiques. Contre-preuve indépendante, car un seul rapport peut être une chance : la période de C divisée par celle de A est 4,086, et le rapport de leurs rayons élevés à trois moyennes est 4,086.
| Planète | Arbre de transmission a (UA) | Période T (années) | T²/a³ | Écart par rapport à la valeur théorique |
| À | 0,89998 | 0,85378 | 0,999985 | −0,0015% |
| B | 1.50005 | 1.83722 | 1.000012 | +0,0012% |
| C | 2.30004 | 3.48822 | 1.000004 | +0,0004% |
Cependant, avec les orbites circulaires, le test est doux, car le rayon moyen et le demi-axe coïncident et il est difficile de se tromper. Ensuite, j’ai augmenté la vitesse initiale de la planète la plus intérieure de 31,396 à 40,796 kilomètres par seconde, dans la plage entre la vitesse circulaire et la vitesse de fuite, et j’ai obtenu une ellipse prononcée. Ici les deux valeurs se séparent : le rayon moyen marque 3,57268 unités astronomiques, le demi-axe 2,88831, soit près de sept dixièmes de différence.
C’est exactement là où un simulateur mal écrit se trahit, car utiliser le rayon moyen au lieu du demi-axe dans la loi de Kepler est l’erreur classique et produit des nombres plausibles mais erronés. Recalculé sur les trois planètes en configuration elliptique, le rapport est de 1,000000, 1,000008 et 1,000001. Il utilise le demi-axe, comme il se doit, et l’écrit également dans une note sous le tableau.
J’ai poussé la planète au-delà de la vitesse de fuite
Une simulation générée se trahit aux extrêmes, pas au centre. Le panneau indiquait pour la planète A une vitesse circulaire de 31,40 kilomètres par seconde et une vitesse de fuite de 44,40. J’ai porté la valeur à 45, juste au-dessus du seuil, et j’ai regardé.
La planète a disparu, comme il se doit. Dans le tableau, le rayon moyen est passé à 8,33564 et au lieu de la période, les mots orbite ouverte avec une période indéfinie sont apparus, tandis que le rapport de Kepler est devenu indisponible. Il n’a pas produit de nombre dénué de sens et il n’a pas commis d’erreur : il a reconnu que la trajectoire était devenue hyperbolique et a arrêté de mesurer quelque chose qui n’existe plus.
Cependant, dans la livraison, il y a une ligne qu’Astra a écrite elle-même, et qui s’applique au reste de la section : Physique numérique et logique de contrôle vérifiées, aperçu visuel bloqué par la politique du navigateur de test. Un contrôle visuel était prévu, elle n’a pas pu le réaliser et au lieu de garder le silence, elle l’a déclaré. Personne n’avait vu ce simulateur avant que je l’ouvre. Pour ceux qui doivent décider d’intégrer ou non un modèle dans un processus métier, savoir distinguer ce qui s’est produit de ce qui ne pourrait pas se produire compte plus que n’importe quel score de référence.
Vingt-quatre tests que personne n’a demandés
La deuxième demande était volontairement vague : un jeu jouable dans le navigateur, une condition de victoire claire, au moins deux niveaux de difficulté croissante, un genre et des graphismes au choix, des commandes au clavier, un travail hors ligne.
Dix-huit secondes après l’envoi, la ligne d’état indiquait quelque chose auquel je ne m’attendais pas dans une discussion vide : la localisation des fichiers AGENTS.md. Il recherchait un fichier d’instructions de projet avant d’écrire une ligne de code, c’est-à-dire qu’il agissait comme un agent à l’intérieur d’un référentiel même en l’absence de référentiel.
Dans une vraie entreprise, ce comportement signifie qu’il suivrait les conventions de l’équipe plutôt que les siennes.
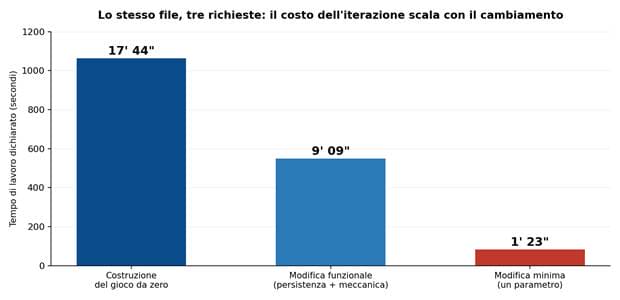
Dix-sept minutes et quarante-quatre secondes plus tard arrivait Echo Shift, un jeu d’arcade d’exploration spatiale avec trois niveaux au lieu des deux requis : collecter des noyaux d’énergie, éviter les drones, atteindre le portail. Commandes sur WASD ou flèches, clic protecteur sur la barre d’espace, pause, niveau de répétition, audio commutable, un panneau d’objectifs avec les trois secteurs et la légende des éléments. Lorsque j’ai quitté la fenêtre, elle s’est arrêtée d’elle-même, avec un message écrit de manière ludique que personne n’avait demandé.
Ensuite l’exigence qui sépare une démo d’un environnement de développement. J’ai demandé deux ajouts à la fois : un enregistrement persistant qui survivrait à la fermeture du navigateur, avec les trois meilleurs temps pour chaque niveau, et une nouvelle mécanique, un noyau instable qui explose au bout de cinq secondes et doit donc être récupéré en premier. Rien d’autre n’avait besoin de changer.
Neuf minutes et neuf secondes. Les deux fonctions étaient là toutes les deux, et dans le discours il a écrit deux phrases que j’ai relues trois fois. La première : le reste du jeu est inchangé, vingt-quatre tests automatiques réussis. Je n’ai demandé aucun test. Il a écrit une suite et l’a exécutée avant de la livrer, et dans les huit cartes de démonstration OpenAI publiées au lancement, ce comportement n’apparaît pas.
La deuxième phrase est encore plus significative : la pause arrête le chronomètre. Personne ne le lui avait dit. Il a compris par lui-même que l’introduction d’un compte à rebours dans un jeu qui dispose déjà d’une fonction pause ouvre un cas critique et l’a fermé avant qu’il ne devienne une faille. C’est le genre de réflexion sur les interactions entre les fonctionnalités qui manque généralement aux prototypes générés, et c’est aussi le genre d’oubli qui coûte un rapport et un cycle de correction en production.
Le plus petit changement possible
Restait la dernière mesure, celle qu’aucune démo ne raconte. J’ai demandé d’augmenter le compte à rebours du noyau instable de cinq à huit secondes, rien d’autre.
Une minute et vingt-trois secondes. Réponse sur une seule ligne : le compte à rebours est passé à huit secondes, rien d’autre n’a changé.
J’ai vu la chose intéressante en ouvrant le fichier. Ce numéro n’apparaissait pas à un seul endroit : c’était sur l’écran initial qui explique les règles, dans la boîte d’instructions latérale et dans le compteur qui défile pendant la partie. Il a mis à jour les trois, sans que je le lui dise et sans toucher à autre chose. Une substitution aveugle de la valeur aurait laissé au moins un texte parlant pendant cinq secondes alors que le jeu en avait huit, et c’est le genre d’incohérence qui dépasse les contrôles automatiques et entre en production.
Placés en enfilade, les trois numéros d’un même dossier racontent une histoire précise. Dix-sept minutes et quarante-quatre secondes pour le construire à partir de zéro, neuf et neuf pour une modification qui affecte la persistance et la logique du jeu, une minute et vingt-trois pour déplacer un paramètre. Le coût de l’itération évolue avec l’ampleur du changement.
Cela semble évident mais ce n’est pas du tout le cas. Un modèle qui réécrit l’intégralité du fichier à chaque requête prend à peu près le même temps, peu importe ce que vous lui demandez, et chaque réécriture est l’occasion de casser quelque chose qui fonctionnait. C’est pourquoi de nombreux prototypes générés meurent à la troisième itération, chaque correctif en introduisant deux autres. Une courbe qui passe de dix-sept minutes à quatre-vingt-trois secondes indique que l’intervention est ciblée et que la base de code reste stable à mesure qu’elle grandit.
Le numéro à amener dans une discussion
Il y a un fil conducteur qui traverse les deux tests, et il ne concerne pas la vitesse. Sur le simulateur, elle déclare ce qu’elle a vérifié et ce qu’elle n’a pas pu vérifier. Elle a écrit et réalisé vingt-quatre tests sur le jeu que je ne lui avais pas demandé. Il produit, contrôle et déclare le résultat du contrôle, et c’est un comportement qui change la manière dont un responsable technique peut déléguer une tâche.
Cependant, ceux qui évaluent ces outils pour une entreprise continuent de regarder le premier plan, c’est-à-dire ce qui est le mieux adapté à être montré lors d’une réunion. Ce n’est pas la bonne mesure, car presque tous les modèles qui existent depuis des mois réussissent le premier coup.
Les questions importantes viennent plus tard. Combien coûte la deuxième demande par rapport à la première ? Si le modèle, quand on lui demande de ne pas toucher au reste, ne touche en réalité pas au reste. S’il vérifie avant de livrer, et s’il déclare lorsqu’il a omis de vérifier. La réponse a été positive sur les quatre points, avec un petit échantillon et aucune répétition, ce qui signifie qu’il s’agit d’un indice et non d’une preuve.
Deux choses que je n’ai pas vérifiées et je les écris ici au lieu de les laisser implicites. Astra déclare que les enregistrements de jeu survivent réellement à la fermeture du navigateur et que dans les jeux auxquels j’ai joué, les trois meilleurs temps par secteur étaient encore vides. Et je n’ai pas vu les vingt-quatre tests automatiques effectués, j’ai lu la déclaration dans la livraison. Jusqu’à ce que j’effectue ces contrôles, les déclarations du fournisseur restent, aussi détaillées soient-elles.
Reste la contrainte qui, d’après mon expérience, décide réellement du retour. Tout ce que j’ai mesuré s’est déroulé dans un environnement entièrement contrôlé par Astra, des fichiers autonomes sans dépendances externes et sans le poids d’un système déjà en fonctionnement. Dans un référentiel d’entreprise avec quinze ans de stratification, ces chiffres seront d’autres chiffres.
La chose sensée à faire, avant de signer une quelconque licence, est de refaire cette mesure exactement sur votre code, chronomètre en main : construction, modification fonctionnelle, modification minime. Ce sont trois nombres, ils s’obtiennent en un après-midi, et ils en disent plus que n’importe quel tableau comparatif.