Sam Altman, PDG de ChatGPT : « C’est assez terrible que les gens aient de la RAM sur leur PC utilisée seulement 5 % du temps »
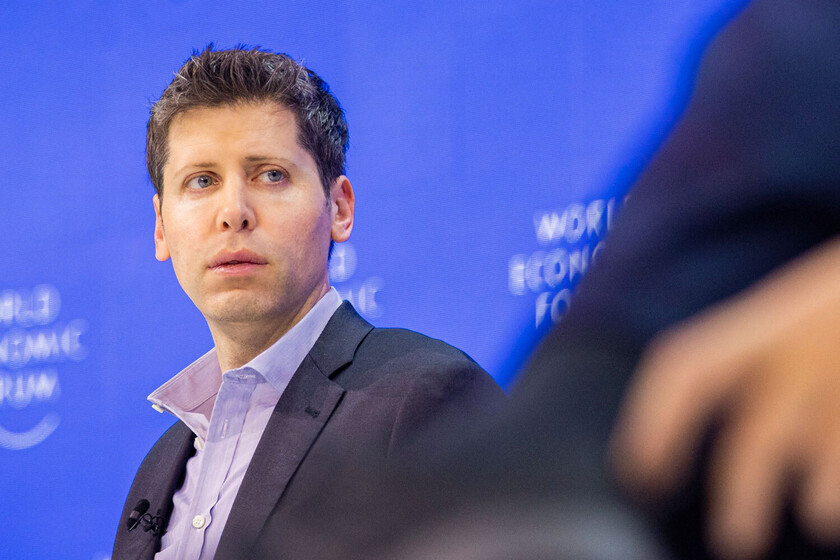
John Collison est le co-fondateur de la plateforme Stripe et propose un podcast appelé Cheeky Pint dans lequel des cadres supérieurs d’entreprises technologiques s’arrêtent pour parler de leurs affaires. Un exemple récent est celui de Susan Li, directrice financière de Meta. Sam Altman, pour sa part, n’a pas besoin d’être présenté, et il y a quelques jours, il s’est arrêté au programme de Collison pour parler de divers sujets. Parmi eux, celui qui semble vous empêcher de dormir la nuit : que chaque utilisateur puisse mettre en place une IA locale.
Cela indique un gaspillage de ressources, mais en arrière-plan il y a le mème « Je me retrouve sans manger ».
En bref. Dans le podcast, ils ont parlé de plusieurs sujets, mais ce qui n’est pas passé inaperçu sur les réseaux, c’est le commentaire du patron d’OpenAI sur la technologie actuelle dans laquelle des utilisateurs prennent des modèles ouverts et les exécutent sur leur propre matériel sans dépendre du cloud de quelqu’un d’autre. Pour Altman, l’inférence locale est un terrible gaspillage d’une ressource aussi rare que la mémoire DRAM :
« L’inférence locale est une terrible allocation de ressources rares. Beaucoup de gens veulent une inférence locale et supposent d’une manière ou d’une autre que le problème est résolu parce que nous avons des modèles open source que nous pouvons exécuter sur nos ordinateurs et que nous n’avons donc pas besoin de toutes ces choses que les centres de données permettent.
Mais du point de vue de l’allocation globale, il est en fait assez terrible que chacun ait son propre ordinateur avec une DRAM qui n’est utilisée que 5 % du temps alors que nous sommes à une époque où cette ressource est si limitée.
Dans cet environnement où cet approvisionnement critique est si limité, vous souhaitez une concentration maximale sur le cloud. Mais d’une manière ou d’une autre, l’idée des gens est le contraire. »
: Si vous disposez d’une IA locale, vous gaspillez des ressources qui auraient pu servir à alimenter un centre de données, selon Altman.
Le truc de la DRAM. Le chiffre de 5% vient d’Altman et c’est pourquoi il estime que c’est un gaspillage pour tout le monde d’avoir quelque chose comme ça chez soi alors que, dans un environnement avec si peu d’offre, on recherche l’utilisation maximale qui ne peut être obtenue que dans un centre de données. Bien sûr, c’est leur point de vue, car de l’autre côté de la médaille, il y a ceux qui ont leur « propre IA » grâce au fait que les modèles ouverts résolvent déjà le problème qu’ils veulent résoudre et, en plus, ils recherchent une plus grande confidentialité que ce qui est obtenu avec ChatGPT.
Du point de vue du PDG d’OpenAI, cette déclaration est tout à fait logique car (et c’est quelque chose qui nous affecte tous et, en particulier, les consommateurs) dans un environnement dans lequel Micron, Samsung ou SK Hynix, qui contrôlent la production de DRAM au niveau mondial, ne peuvent pas augmenter cette production au rythme dont ont besoin les hyperscalers, toute la capacité mondiale devrait actuellement aller aux centres de données, et non aux équipements faits maison.
Personne ne l’aurait deviné il y a cinq ans, lorsque les prix étaient au plus bas, mais la DRAM est actuellement une denrée critique et rare, avec des prix qui, selon TrendForce, ont augmenté entre 90 % et 95 % au premier trimestre 2026… et il n’y a aucun signe de baisse à court terme. Bien au contraire.
Contexte. Et ce commentaire est intervenu à un moment de la conversation qui traitait des pénuries informatiques. Altman affirme que le marché ne réagit pas comme il le devrait et que les grands fabricants de mémoire, malgré les énormes bénéfices qu’ils ont réalisés au cours des douze derniers mois, maintiennent un investissement conservateur par rapport à ce que la situation exige.
Les trois grands se sont déplacés pour permettre de nouvelles usines de production, limitant même la production de puces grand public afin que toutes les machines soient équipées de la mémoire HBM nécessaire aux centres de données, mais c’est précisément un segment dans lequel il n’est pas facile de changer les choses du jour au lendemain et d’ouvrir de nouvelles usines de mémoire hautes performances.
Qu’ils le disent à la Chine, qui fonctionne depuis des mois en option dans le segment DRAM, mais pour le moment plus que pour HBM, ils se positionnent sur le segment des mémoires grand public en raison de ces exigences sur les puces de pointe que j’ai mentionnées il y a un instant.
Solution. En plus d’être généreux et de ne pas acheter de composants qu’OpenAI pourrait utiliser, Altman propose que de nouveaux acteurs entrent dans la chaîne d’approvisionnement comme remède.
Par exemple, OpenAI développe ses propres puces avec Broadcom (Jalapeño) et, même si ils auraient toujours besoin de DRAM, fabriquer une puce personnalisée permet d’optimiser beaucoup plus le tout. SpaceX est dans la même situation, tout comme Amazon, Meta, Microsoft ou Google qui a un peu plus d’expérience avec ses TPU.
Niche. Malgré tout, OpenAI a lancé gpt-oss en août 2025, ses premiers poids ouverts depuis GPT-2 conçus pour pouvoir fonctionner localement et Altman lui-même a déclaré en janvier de la même année qu’OpenAI s’était trompé sur l’open source. Bien entendu, au début de l’année 2025, il n’y avait pas actuellement de crise de la DRAM.
En fin de compte, ma question ici est de savoir si Altman considère que le segment d’utilisateurs qui utilisent l’IA locale est si important et s’ils causent réellement autant de dégâts à la chaîne d’approvisionnement alors que l’on voit que les gens ne paient pas pour l’IA parce que ce qui est proposé « gratuitement » répond déjà à leurs besoins.
Quiconque possède une machine capable d’exécuter un modèle local sait parfaitement pourquoi il le fait et cela peut être dû à des besoins spécifiques, pour pouvoir l’utiliser hors ligne, ou simplement parce qu’il ne fait pas confiance à la sécurité d’une entreprise comme OpenAI.
Images | Flickr (Forum économique mondial)
À Simseo | Nvidia veut que RTX Spark marque un avant et un après sur PC : après l’avoir vu en action, cela ne semble pas fou