Claude Sonnet 5.5 : coûts, benchmarks et stratégie Anthropique
Anthropic s’efforce de réduire le coût économique de l’intelligence artificielle générative. Le 28 septembre 2026, l’entreprise a présenté le Claude Sonnet 5.5, le deuxième modèle de la famille 5.5 après l’Opus 5.5 arrivé six jours plus tôt. Plus de 30 % plus rapide que Sonnet 5 et, pour la plupart des tâches, un coût jusqu’à 30 % inférieur par tâche terminée. Les prix nominaux des abeilles ne changent cependant pas.
Ce choix indique où évolue la concurrence entre les grands développeurs de modèles. Le pouvoir absolu reste important, mais pour les entreprises, acheter de l’IA signifie de plus en plus mesurer combien coûte la réalisation d’une tâche : corriger un logiciel, analyser des documents, construire une présentation, interroger une base de données ou faire travailler un agent pendant des dizaines d’étapes consécutives.
Sonnet 5.5 a été créé exactement pour ce segment de marché. Anthropic le présente comme le complément le plus rapide et le plus économique de Claude Opus 5.5, ciblant Opus pour les problèmes ouverts et complexes qui nécessitent un plus grand jugement et Sonnet pour les tâches quotidiennes bien définies, du codage à la production de documents, feuilles de calcul et présentations.
Les prix restent inchangés, le coût par activité change
Claude Sonnet 5.5 coûte 2 $ par million de jetons d’entrée et 10 $ par million de jetons de sortie. La lecture des données déjà dans le cache coûte 0,20 $ par million de jetons. Ce sont les mêmes tarifs que Sonnet 5, qu’Anthropic a rendu permanent en août 2026 après une précédente hypothèse d’augmentation.
Le point économique est donc différent de la simple réduction du tarif. Anthropic affirme que Sonnet 5.5 nécessite, dans la plupart des cas, moins de ressources pour atteindre le même résultat et peut ainsi réduire le coût global d’une activité jusqu’à 30 %.
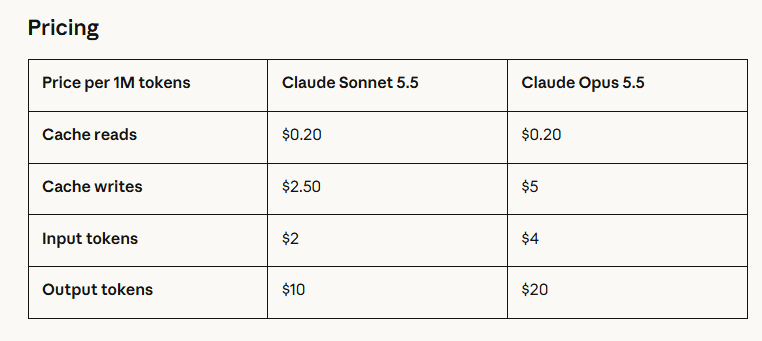
Ce critère est particulièrement important chez les agents IA. Une application qui effectue des dizaines ou des centaines d’appels de modèles peut générer une consommation très différente de celle suggérée par le prix d’un seul million de tokens. Le nombre d’étapes, la quantité de texte produit, l’utilisation d’outils externes, les relectures du cache et le niveau de raisonnement attribué au modèle entrent en compte.
En effet, Anthropic permet de réguler « l’effort », c’est-à-dire la quantité de travail de calcul dédié à une requête. Dans les applications Claude et Claude Code, le niveau par défaut est Moyen, tandis que sur la plateforme développeur, il est Élevé. En montant d’un niveau, le modèle peut travailler plus longtemps et avoir plus de contrôle sur le résultat, mais la consommation augmente également.
Les références anthropiques marquent un fort bond
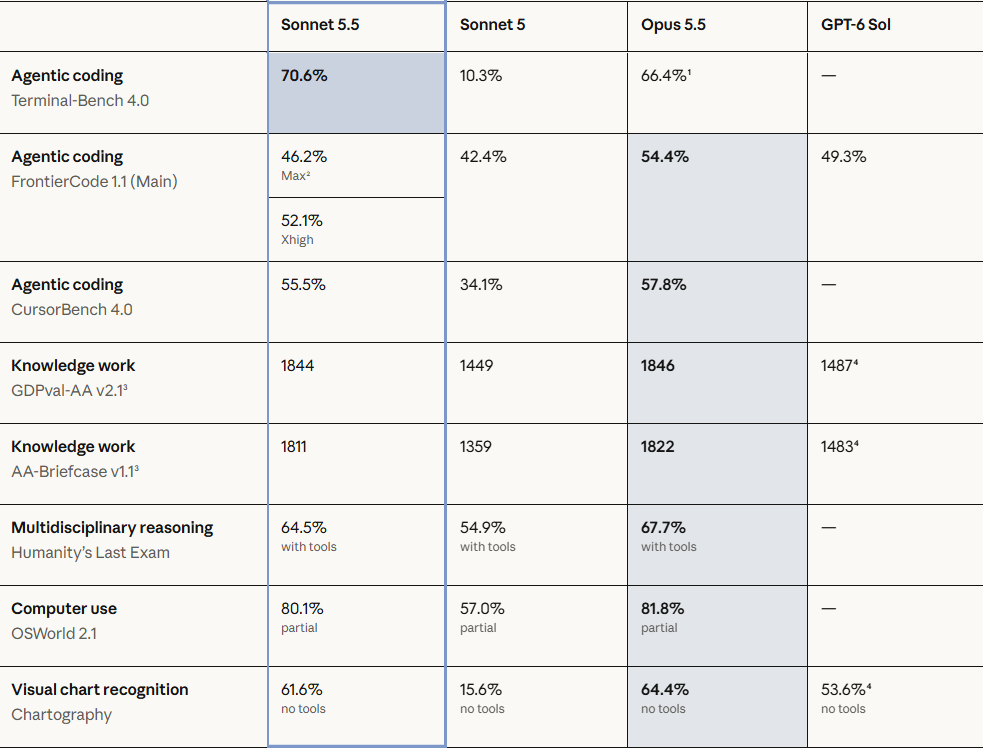
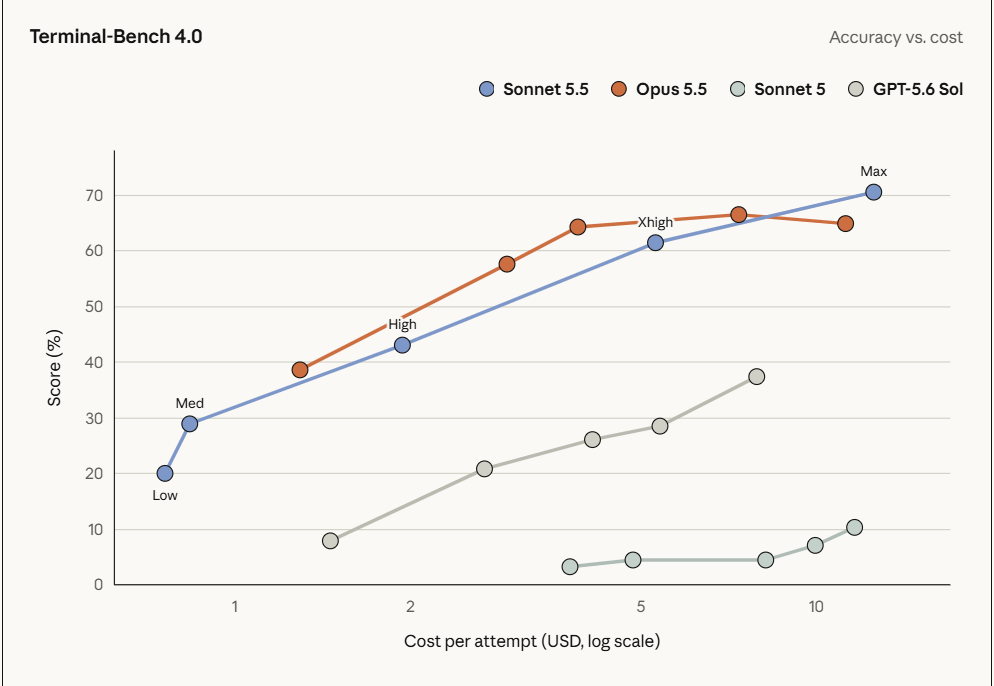
Les chiffres publiés par l’entreprise montrent des différences marquées par rapport à Sonnet 5. Banc de terminaux 4.0test dédié aux activités professionnelles en plusieurs étapes réalisées via un terminal, Sonnet 5.5 atteint 70,6%, contre les 10,3% déclarés pour Sonnet 5.
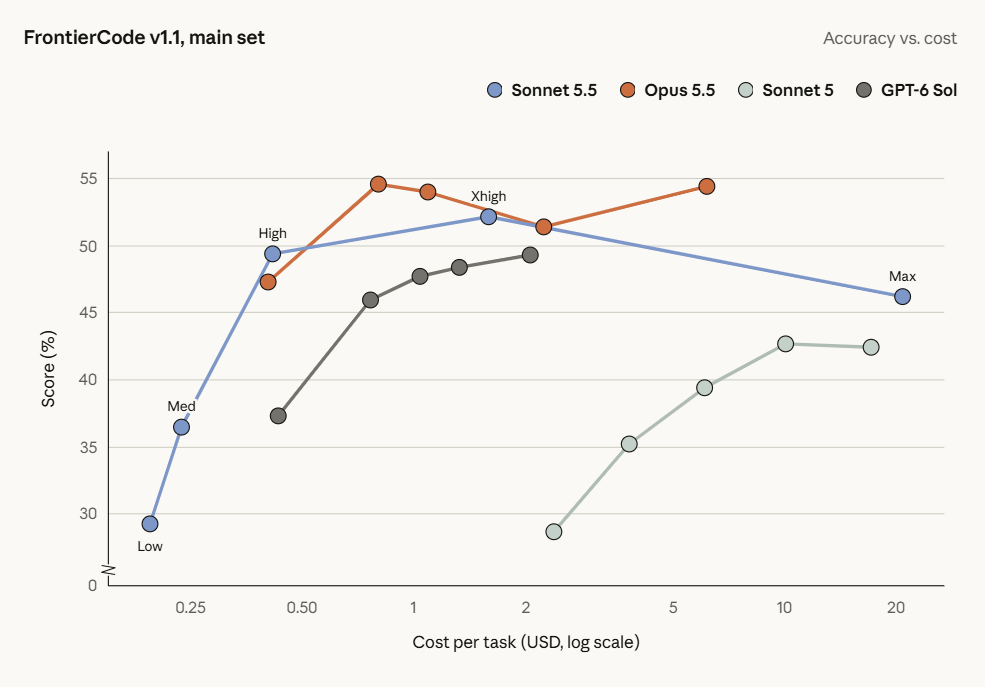
Dans l’essai Code Frontière 1.1 le résultat maximum indiqué par Anthropic atteint 52,1% avec le niveau Xhaut,
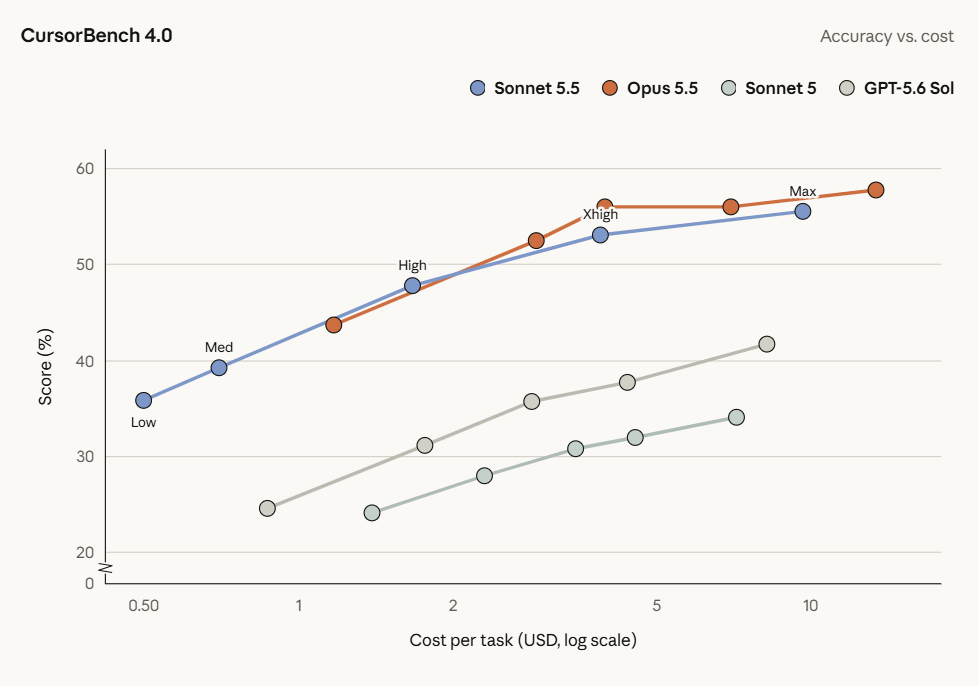
Alors que CursorBench 4.0 donne au nouveau modèle 55,5%, contre 34,1% pour le Sonnet 5.
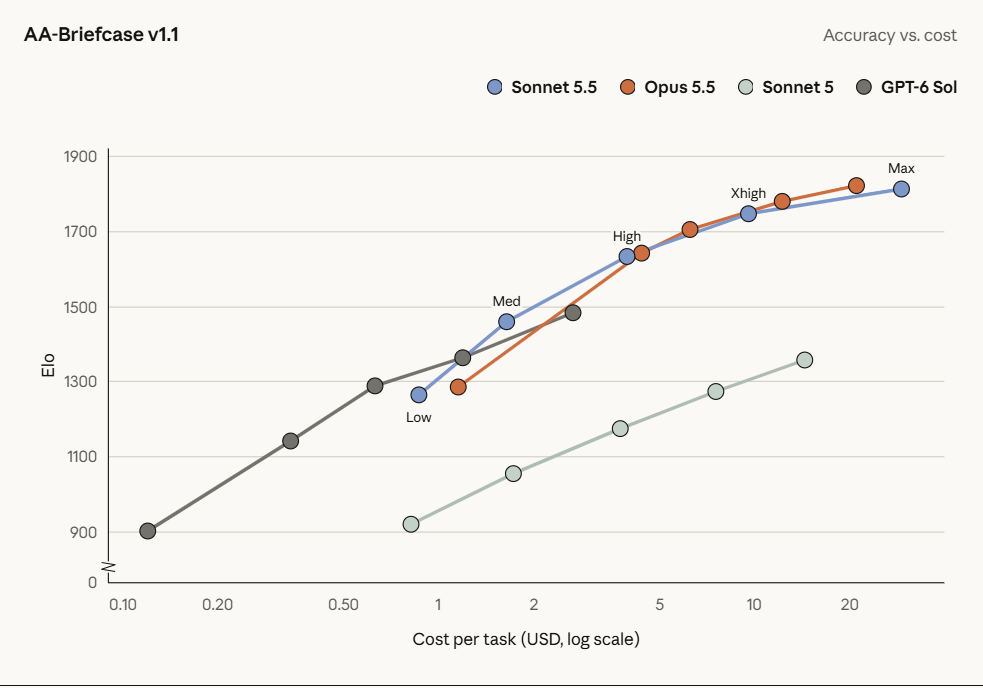
Pour un travail professionnel, GDPval-AA v2.1 donne à Sonnet une note de 5,5 Élo de 1 844, presque identique aux 1 846 points de l’Opus 5.5. Sur AA-Briefcase, la comparaison est de 1 811 contre 1 822.
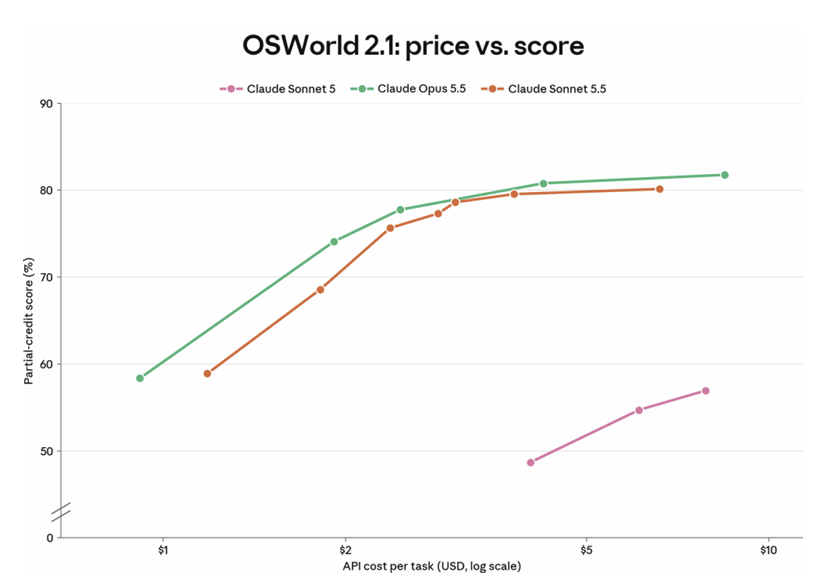
Anthropic indique également des progrès dans l’utilisation de l’ordinateur et la compréhension visuelle : 80,1 % en hausse OSWorld 2.1 et 61,6% en hausse Chartographie.
Le dernier examen de l’humanitéexécuté avec des outils, donne au modèle 64,5%, contre 54,9% pour son prédécesseur et 67,7% pour l’Opus 5.5.
Anthropic lui-même prévient que les tests standardisés ne mesurent qu’une partie des capacités d’un modèle et continue de désigner l’Opus 5.5 comme le produit supérieur pour les tâches complexes, ouvertes et prolongées.
Un test indépendant complique le tableau des coûts
Cependant, certaines données utiles proviennent de la relation entre performance et dépenses. Analyse artificielleune entreprise qui effectue des comparaisons de modèles indépendantes. Lors des tests publiés le 28 septembre, Sonnet 5.5 avec effort maximum a obtenu 56 points dans le‘Indice d’intelligence d’analyse artificiellesoit deux points de moins que l’Opus 5.5. Cependant, le laboratoire a enregistré environ 193 000 jetons de sortie par tâche, le niveau le plus élevé détecté lors de ses tests.
Selon Artificial Analysis, dans cette configuration spécifique, le coût moyen a atteint 7,60 $ par tâche, soit environ 50 % de plus que Sonnet 5. Le résultat ne réfute pas nécessairement la déclaration d’Anthropic, car il compare un ensemble particulier de tests effectués au niveau d’effort maximum, tandis que l’entreprise parle d’économies « jusqu’à 30 % » sur la plupart des tâches et souligne surtout l’efficacité des niveaux faible et moyen.
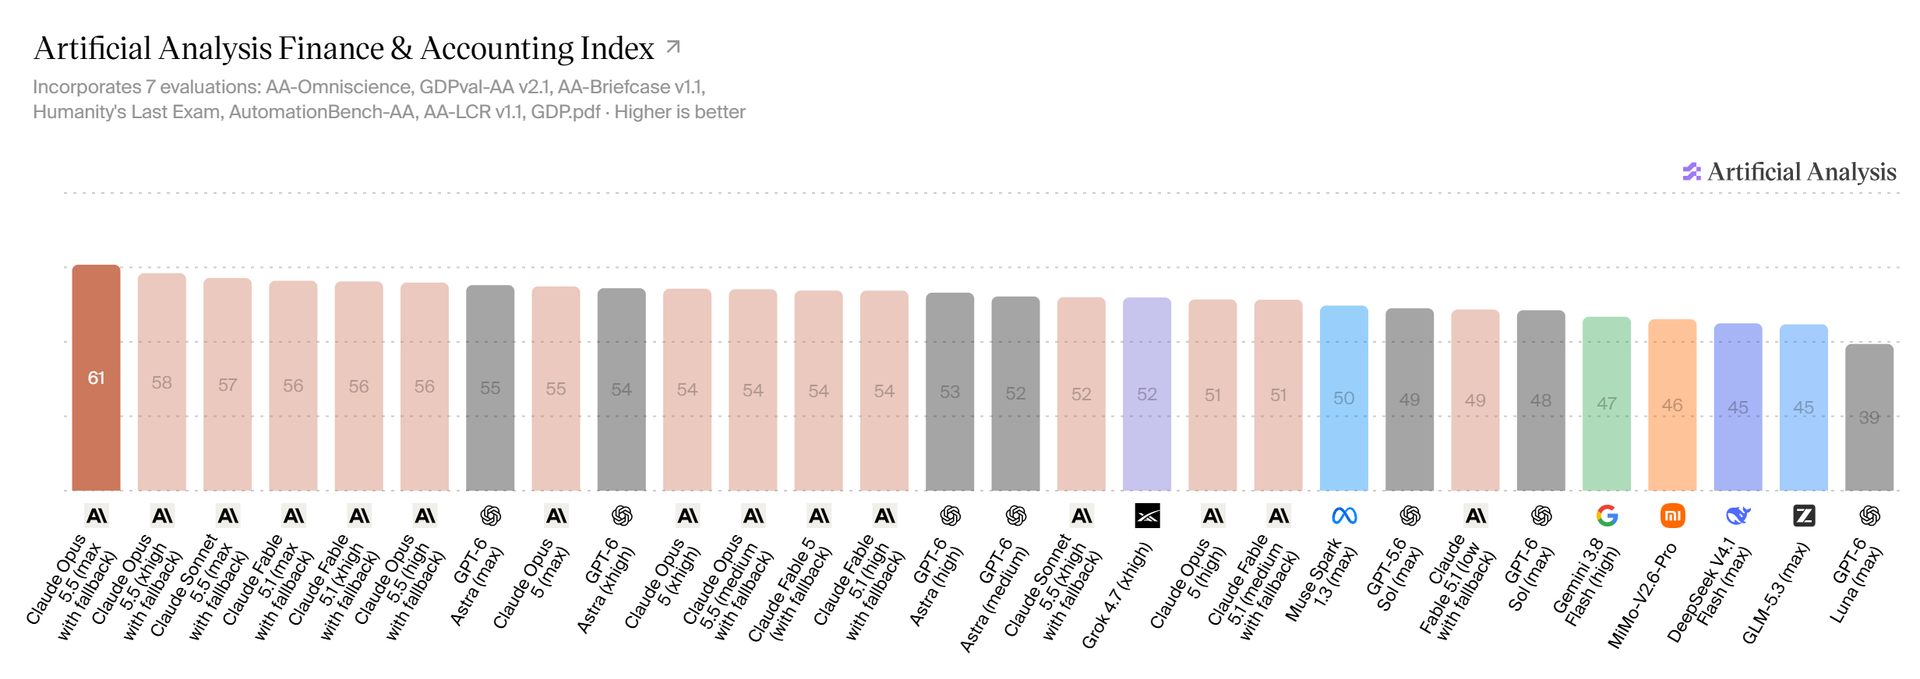
La différence clarifie cependant un point pour les entreprises qui achètent des capacités d’IA : le prix par million de tokens ne suffit plus à estimer le coût de production. Deux modèles avec le même tarif peuvent générer une facture différente si l’on utilise plusieurs tokens, appelle plusieurs fois des outils externes ou prolonge le raisonnement.
La mesure utile devient alors le coût par résultat acceptable. Un modèle par appel plus coûteux peut s’avérer pratique s’il permet d’effectuer le travail en quelques étapes seulement ; celui avec une liste de prix inférieure peut perdre l’avantage s’il nécessite de nombreuses itérations.
Le codage et le travail de bureau sont le marché prioritaire
Anthropic concentre une grande partie de sa communication sur deux domaines : le développement de logiciels et le travail de connaissances. En matière de codage, la société affirme que Sonnet 5.5 comprend une base de code plus rapidement et a tendance à regrouper les appels d’outils, réduisant ainsi le nombre d’étapes nécessaires.
Jeux épiquesimpliqué dans les tests préliminaires cités par Anthropic, a rapporté que le modèle gérait des dizaines de milliers de lignes de code dans des tâches liées à l’architecture des systèmes de jeu et à l’examen des flux de données.
Mou a déclaré que, sans modifier les invites de ses tests Slackbot internes, Sonnet 5.5 a surpassé Sonnet 5 dans presque toutes les évaluations en utilisant environ 14 % de jetons de sortie en moins.
Il s’agit de notes émanant d’entreprises partenaires et rapportées par le fabricant, et non de références indépendantes. Cependant, ils indiquent le terrain commercial sur lequel Anthropic souhaite positionner le produit : des charges de travail répétables, déjà incluses dans les processus de l’entreprise et donc mesurables en termes de temps, de token et de coût.
La même stratégie ressort des exemples relatifs aux documents, analyses financières, interfaces et présentations. Anthropic affirme avoir soumis au modèle des documents trimestriels et des transcriptions de conférences téléphoniques d’une société cotée, lui demandant de produire une présentation opérationnelle en dix diapositives. Selon l’entreprise, deux évaluateurs ont jugé le premier résultat déjà utilisable sans changements substantiels.
AWS, Google Cloud et Microsoft étendent immédiatement leur distribution
La capacité d’Anthropic à transformer les améliorations techniques en revenus dépend également de la distribution. Sonnet 5.5 est arrivé immédiatement sur les principaux écosystèmes cloud.
AWS a annoncé sa disponibilité le 28 septembre via Socle amazonien soit par Plateforme Claude sur AWS. Bedrock permet aux entreprises d’utiliser le modèle en conservant les données dans l’infrastructure AWS et en les intégrant à des services tels que la gestion des identités et des accès, CloudTrail, CloudWatch et Bedrock Guardrails.
Google Cloud répertorie Claude Sonnet 5.5 comme généralement disponible et spécifie une fenêtre contextuelle maximale d’un million de jetons et jusqu’à 128 000 jetons de sortie. Le service prend en charge la saisie de texte, d’image et de PDF, ainsi que l’utilisation d’un ordinateur, la recherche sur le Web, l’appel de fonctions et la mise en cache des invites. Google signale également une disponibilité multirégionale en Europe.
Microsoft a annoncé le même jour la disponibilité du modèle dans Microsoft Foundry, le présentant comme une option pour les applications et agents d’IA destinés au codage et au travail de connaissances.
Pour Anthropic, la présence simultanée dans les trois grands cloud réduit l’un des obstacles à l’adoption par les entreprises : les entreprises peuvent utiliser Claude sans nécessairement déplacer les infrastructures, les systèmes de contrôle et les procédures d’achat déjà construits autour de leur fournisseur de cloud.
La famille 5.5 se concentre sur la segmentation des charges
Sonnet 5.5 arrive six jours après Claude Opus 5.5, présenté le 22 septembre. Anthropic affirme que l’Opus 5.5 coûte environ 40 % moins cher à exécuter que l’Opus 5 et le positionne pour des tâches longues et complexes. La société a également anticipé l’arrivée dans les semaines suivantes de Haiku 5.5, destiné aux chargements à gros volume et plus sensibles aux prix.
Une structure à trois niveaux se dessine ainsi :
- Opus supervise les travaux qui nécessitent plus de compétences et de jugement ;
- Sonnet vise le rapport entre qualité, rapidité et coût ;
- Le haïku doit absorber les activités les plus fréquentes et standardisées.
Pour les entreprises clientes, la conséquence peut être une plus grande sélection de modèles en fonction de la tâche individuelle. Un agent peut sous-traiter des opérations simples selon un modèle économique, passer à Sonnet pour le développement de logiciels ou des analyses structurées, et réserver Opus pour des décisions ou des tâches qui nécessitent plusieurs étapes et vérifications.
Cette architecture déplace une partie de la concurrence du modèle unique vers l’orchestration : ce qui compte, c’est le coût de l’ensemble du processus, et pas seulement le modèle qui obtient le score le plus élevé.
La cybersécurité et les contrôles entrent dans le coût industriel
L’augmentation des compétences en codage entraîne également de nouveaux contrôles. Anthropic affirme que les performances de cybersécurité de Sonnet 5.5 sont suffisamment solides pour nécessiter pour la première fois sur un modèle Sonnet des protections et des mécanismes de secours similaires à ceux utilisés sur les modèles Opus plus puissants.
La société maintient également les contrôles de biosécurité déjà en place sur Sonnet 5 et introduit des classificateurs destinés à contrecarrer les attaques de « distillation », dans lesquelles de grandes quantités de comptes sont utilisées pour extraire systématiquement des capacités d’un modèle propriétaire.
Pour les entreprises, ces éléments ont un impact économique moins visible que le prix des tokens, mais ils entrent dans le choix de la plateforme. La disponibilité régionale, la conservation des données, les audits, les contrôles d’accès et les systèmes de sécurité ont un impact sur le coût total d’adoption autant que sur les frais de l’API, en particulier dans les secteurs réglementés.
La compétition passe du symbolique à l’œuvre achevée
Avec Sonnet 5.5, Anthropic maintient le prix unitaire inchangé et essaie de vendre plus de productivité pour chaque dollar dépensé. Il s’agit d’une étape importante pour un marché dans lequel les performances des modèles haut de gamme s’approchent de différents critères et où les entreprises doivent justifier l’augmentation des budgets d’IA par des résultats mesurables.
Les données publiées par le constructeur indiquent de très forts progrès par rapport à Sonnet 5. Toutefois, les premiers tests indépendants montrent que les configurations gourmandes en raisonnement peuvent consommer un grand nombre de tokens. Pour ceux qui achètent des services d’IA, la comparaison doit donc inclure au moins trois variables : la qualité du résultat, le temps nécessaire pour l’obtenir et le coût global de la tâche.
C’est sur cette combinaison qu’Anthropic construit la famille Claude 5.5. Si l’IA d’entreprise passe d’assistants qui répondent à une question à des agents qui réalisent des séquences opérationnelles entières, l’unité économique à contrôler ne sera plus le million de tokens achetés, mais le prix du travail effectivement réalisé.
Cliquez ici pour la carte système Sonnet 5.5