GPT-6 Sol et Luna : moitié prix et benchmarks API et agents
OpenAI élargit la famille GPT-6 avec Sol et Luna, deux modèles qui apportent une partie des capacités introduites avec GPT-6 Astra vers des gammes de prix inférieures. Les nouveaux systèmes ont été annoncés le 22 septembre 2026 et se concentrent avant tout sur la relation entre capacité, vitesse et coût : un élément qui devient de plus en plus important lorsque les modèles sont utilisés pour des agents logiciels, des programmes et des processus métiers qui consomment de grandes quantités de jetons.
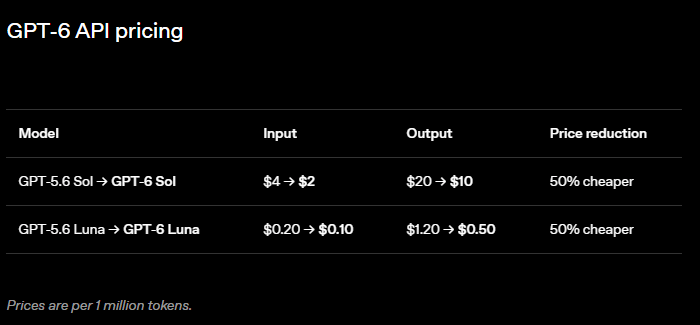
L’actualité la plus immédiate concerne les prix. Pour GPT-6 Sol OpenAI indique 2 dollars par million de jetons en entrée et 10 dollars par million en sortie dans la tarification standard indiquée au lancement. GPT-6 Luna tombe respectivement à 0,10 $ et 0,50 $. OpenAI présente ces valeurs comme une réduction de 50 % par rapport aux prix promotionnels des modèles GPT-5.6 correspondants.
Le journal des modifications de l’API publiée le 22 septembre confirme les prix et la disponibilité des deux nouveaux modèles.
Sol et Luna occupent deux groupes différents
La structure de la nouvelle famille clarifie la stratégie d’OpenAI.
GPT-6 Astra reste le modèle destiné aux tâches les plus difficiles, avec une plus grande capacité de raisonnement et un coût plus élevé.
GPT-6 Sol occupe la gamme intermédiaire : la documentation officielle le décrit comme un modèle conçu pour équilibrer capacité et coût, en particulier pour les workflows complexes de codage et d’agent.
Luna se concentre plutôt sur des charges à volume élevé et des activités plus limitées, où le coût par demande pèse plus que la capacité maximale disponible.
Les trois modèles acceptent du texte et des images et disposent, selon le catalogue OpenAI, d’une fenêtre contextuelle allant jusqu’à 1,05 million de jetons et d’une sortie maximale de 128 000 jetons. Sol et Luna peuvent également fonctionner avec différents niveaux d’effort de raisonnement, depuis le fonctionnement sans raisonnement approfondi jusqu’aux modes les plus exigeants.
L’objectif déclaré n’est donc pas de remplacer Astra, mais de rendre économiquement durables des applications dans lesquelles toujours utiliser le modèle haut de gamme serait trop coûteux. Le problème concerne principalement les agents : une seule tâche peut nécessiter de nombreux appels de modèle, consultations d’outils, analyse de fichiers et itérations ultérieures. Dans ces cas-là, le coût de chaque étape s’accumule rapidement.
La raison du choix des prénoms d’origine latine
Les noms sont en réalité d’origine latine : sol signifie « soleil », luna signifie « lune », tandis que terra signifie « terre ». Ce sont donc des mots latins qui sont également entrés presque inchangés en italien. Avec GPT-6, OpenAI a conservé Sol et Luna et a appelé le modèle phare Astra, un autre mot latin, pluriel de astrec’est-à-dire « asts » ou « étoiles ». L’entreprise parle explicitement de la « famille » GPT-6 composée d’Astra, Sol et Luna.
La lecture la plus plausible – mais nous sommes ici dans le domaine de l’interprétation, pas d’une explication officielle – est qu’OpenAI a choisi un lexique astronomique latin pour rendre la hiérarchie familiale plus reconnaissable par rapport aux anciennes étiquettes purement techniques comme « mini » ou « nano ». Les trois noms créent également un système facile à retenir et utilisable dans de nombreuses langues.
OpenAI, du moins dans les sources officielles publiées jusqu’à présent, n’attribue pas à Sol, Luna ou Astra une signification symbolique hiérarchique précise du type « le Soleil est plus puissant que la Lune ». La hiérarchie est plutôt déclarée dans les descriptions des produits : Astra est le modèle phare, Sol vise l’équilibre entre capacité et coût, Luna l’efficacité pour les activités ciblées et à gros volume.
Repères de travail professionnel
OpenAI accompagne le lancement d’une série de tests sur les activités professionnelles. Les données sont produites ou sélectionnées par l’entreprise et doivent donc être lues pour ce qu’elles mesurent : comparaisons faites avec des configurations spécifiques, niveaux d’effort de raisonnement et coûts par tâche.
Sur AutomationBench 1.0.6, un benchmark qui évalue le workflow de bout en bout à travers 47 outils utilisés dans les ventes, le marketing, les opérations, l’assistance, la finance et les ressources humaines, GPT-6 Sol en mode xhigh obtient un score de 33,2% selon OpenAI.
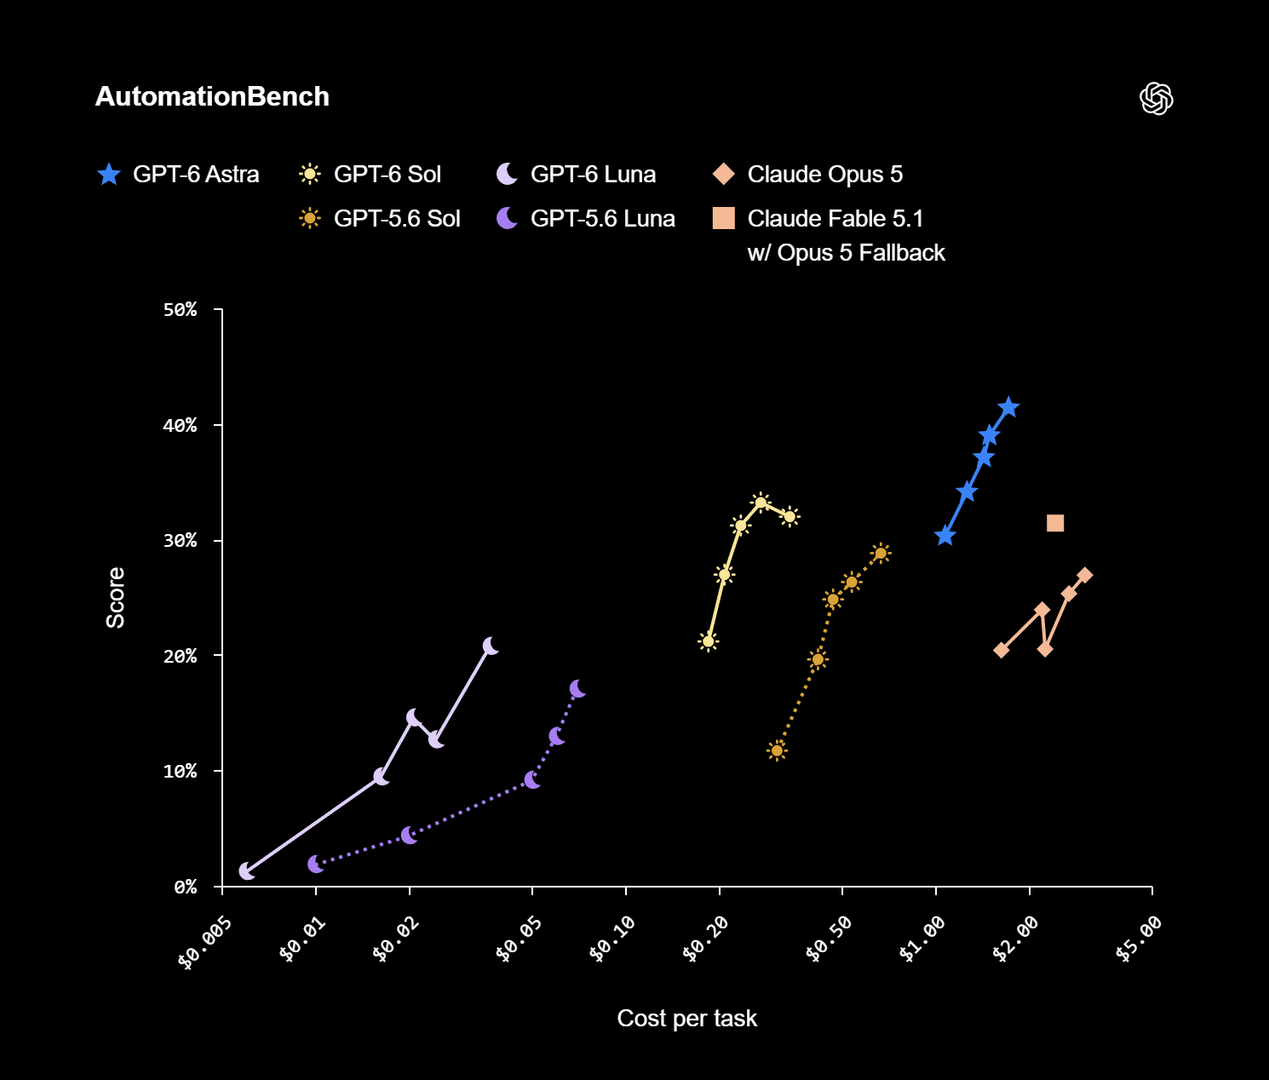
Claude Opus 5, dans la configuration max utilisée dans le comparatif, atteint 26,9%. La différence économique indiquée est plus marquée : une tâche avec Sol coûte 0,27 dollars, tandis que le coût attribué à Opus 5 est 11,1 fois plus élevé.
Dans le même test GPT-6, Astra en mode bas atteint 30,3 %, avec un coût par activité qu’OpenAI quantifie à 3,9 fois celui de Sol.
Claude Fable 5.1 avec retomber sur l’Opus 5, il atteint 31,4 % ; dans le matériel OpenAI, il précise que le coût rapporté pour cette configuration n’inclut pas celui des replis, survenus sur environ 40% des activités.
Un deuxième test, Agents’ Last Exam V1, couvre les activités professionnelles de longue durée réparties dans 55 sous-secteurs.
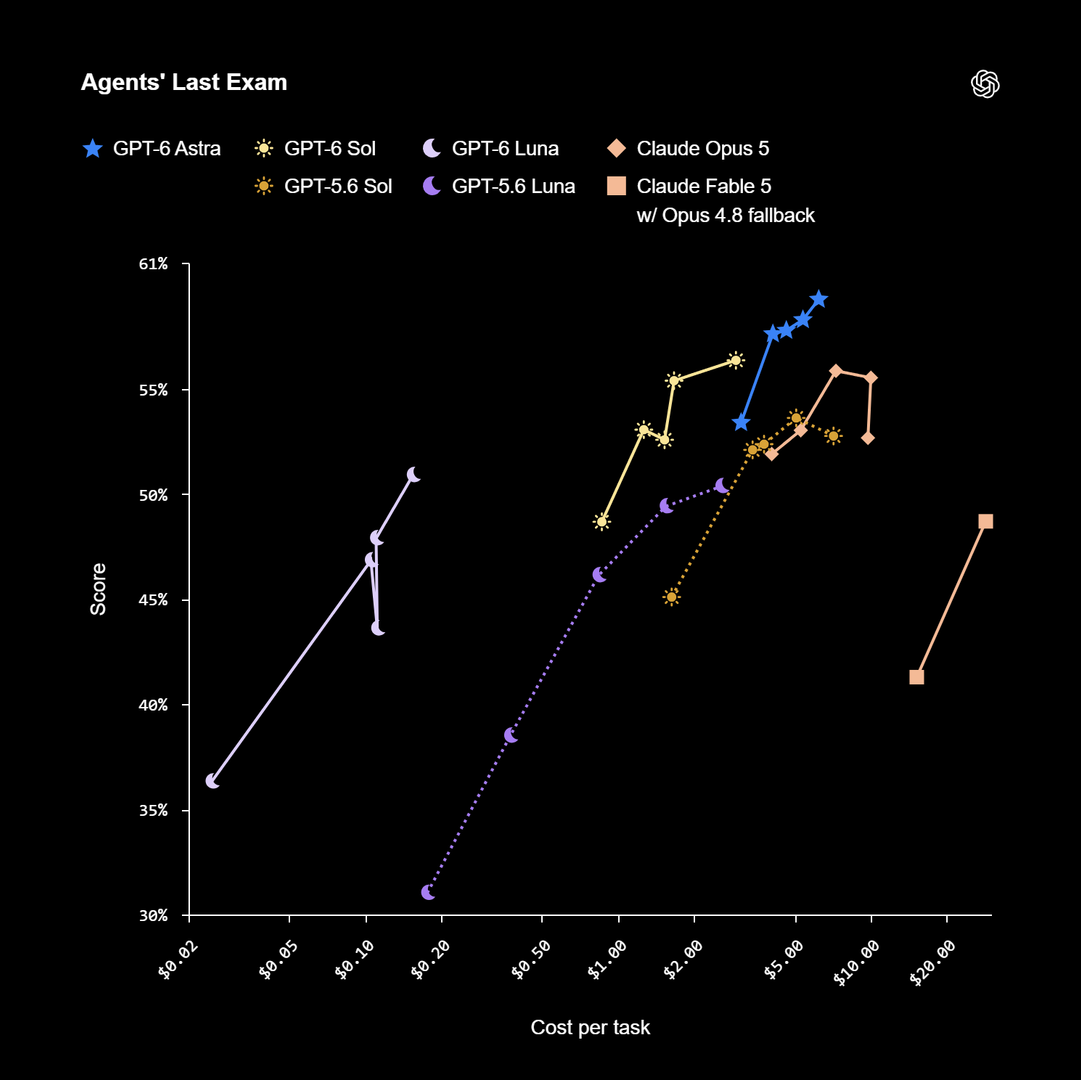
OpenAI donne à GPT-6 Sol en configuration max un résultat de 56,4% et affirme que le modèle atteint ce niveau avec un coût par tâche 60% inférieur à la meilleure configuration Claude Opus 5 examinée dans le comparatif.
Codage : le coût devient partie intégrante de la performance
La relation entre prix et capacité revêt une importance particulière dans le développement de logiciels. Les agents de codage peuvent fonctionner pendant de nombreuses itérations consécutives, lisant des référentiels, modifiant des fichiers, exécutant des tests et corrigeant les erreurs produites lors des phases précédentes.
Dans le matériel de lancement, OpenAI cite sa propre utilisation interne comme exemple de la croissance de ces charges utiles. En évaluant les jetons aux prix de l’API, la société affirme que l’utilisation quotidienne dépassait l’équivalent de 600 dollars pour le chercheur médian et de 7 000 dollars pour les chercheurs placés dans le quatre-vingt-dixième centile. Le graphique ne décrit pas les dépenses individuelles normales : il sert à montrer à quel point la consommation peut devenir élevée lorsque les agents sont utilisés de manière intensive.
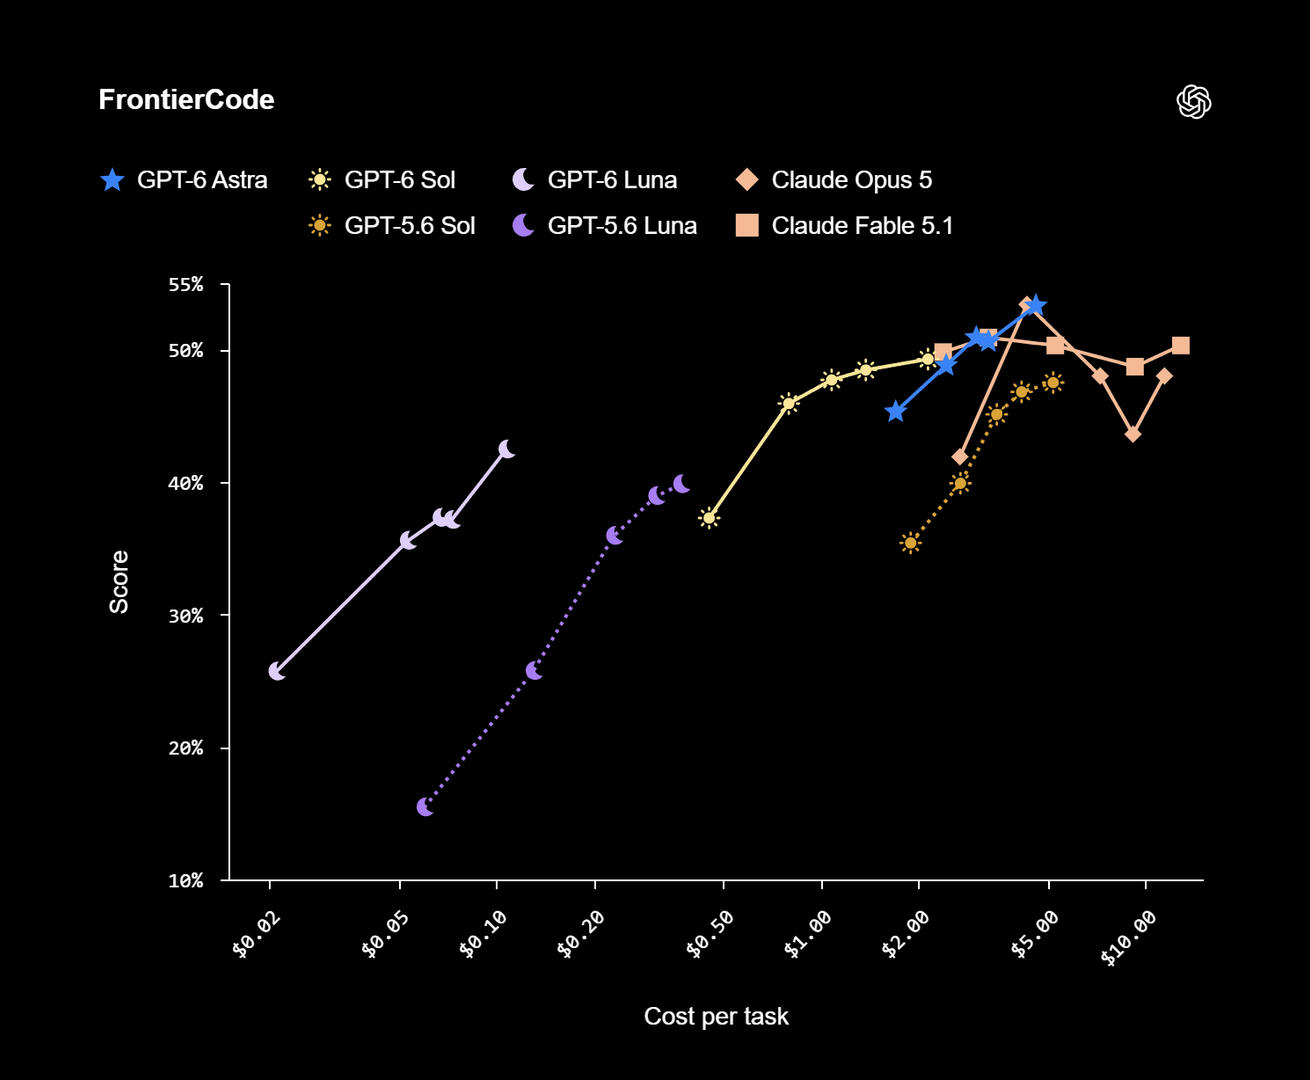
Sur FrontierCode 1.1 Main, un benchmark qui évalue également le « fusionnabilité » du code du produit – donc pas seulement l’exactitude, mais des aspects tels que la qualité des tests, la discipline de la portée, le style et le respect des conventions du référentiel – OpenAI rapporte une amélioration de Sol par rapport à GPT-5.6 Sol et des performances comparables à Claude Fable 5.1 xhigh à un coût inférieur.
La comparaison se poursuit avec DeepSWE 1.1, dédié aux problèmes de génie logiciel de longue durée dans des référentiels réels. GPT-6 Sol en mode max atteint, dans les résultats rapportés par OpenAI, 68,8%, contre les 69,9% attribués à la meilleure configuration Claude Fable 5 considérée par l’entreprise. OpenAI estime un coût par tâche environ 80 % inférieur pour Sol.
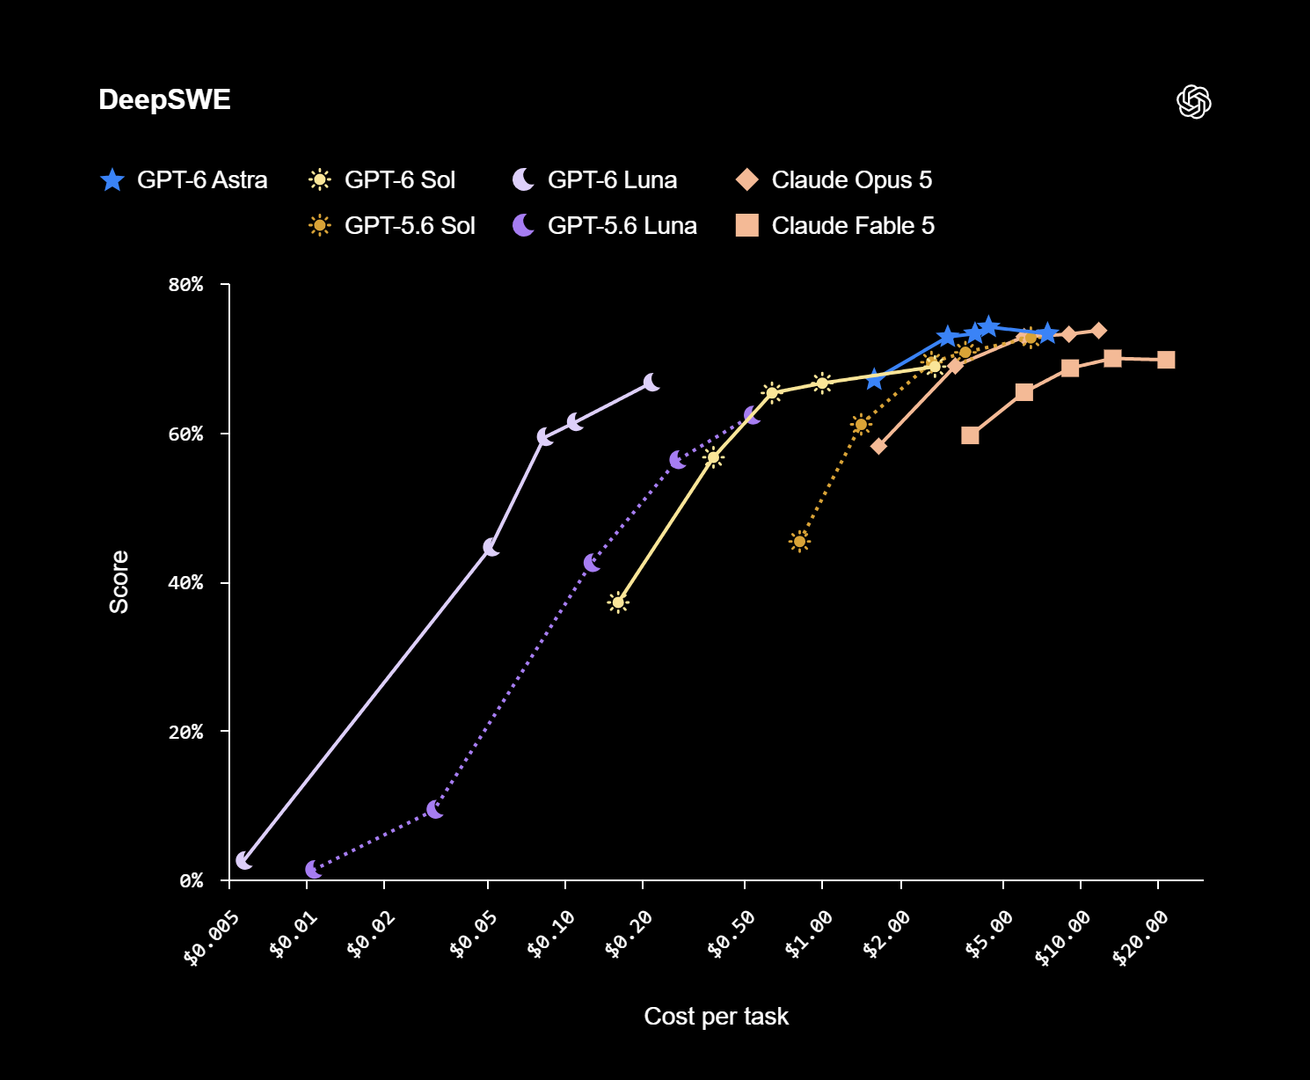
GPT-6 Luna atteint 66,6% en configuration maximale. L’entreprise le compare à Claude Opus 5 et Fable 5 en mode moyen et indique des réductions de coût par tâche de 93 % et 96 % respectivement. Ce sont ces données qui définissent le mieux le positionnement de Luna : des performances qu’OpenAI présente comme suffisantes pour de nombreux workflows techniques, avec un coût par exécution très faible.
Moins d’erreurs factuelles, selon des tests internes
Un deuxième domaine sur lequel OpenAI concentre son lancement est la fiabilité des réponses. Le test cité par la société utilise des conversations ChatGPT anonymisées dans lesquelles les utilisateurs ont signalé une erreur factuelle produite par un modèle précédent.
Dans cette évaluation, GPT-6 Sol commet, selon OpenAI, environ la moitié des erreurs de son prédécesseur GPT-5.6 Sol et se rapproche des résultats d’Astra avec un coût inférieur.
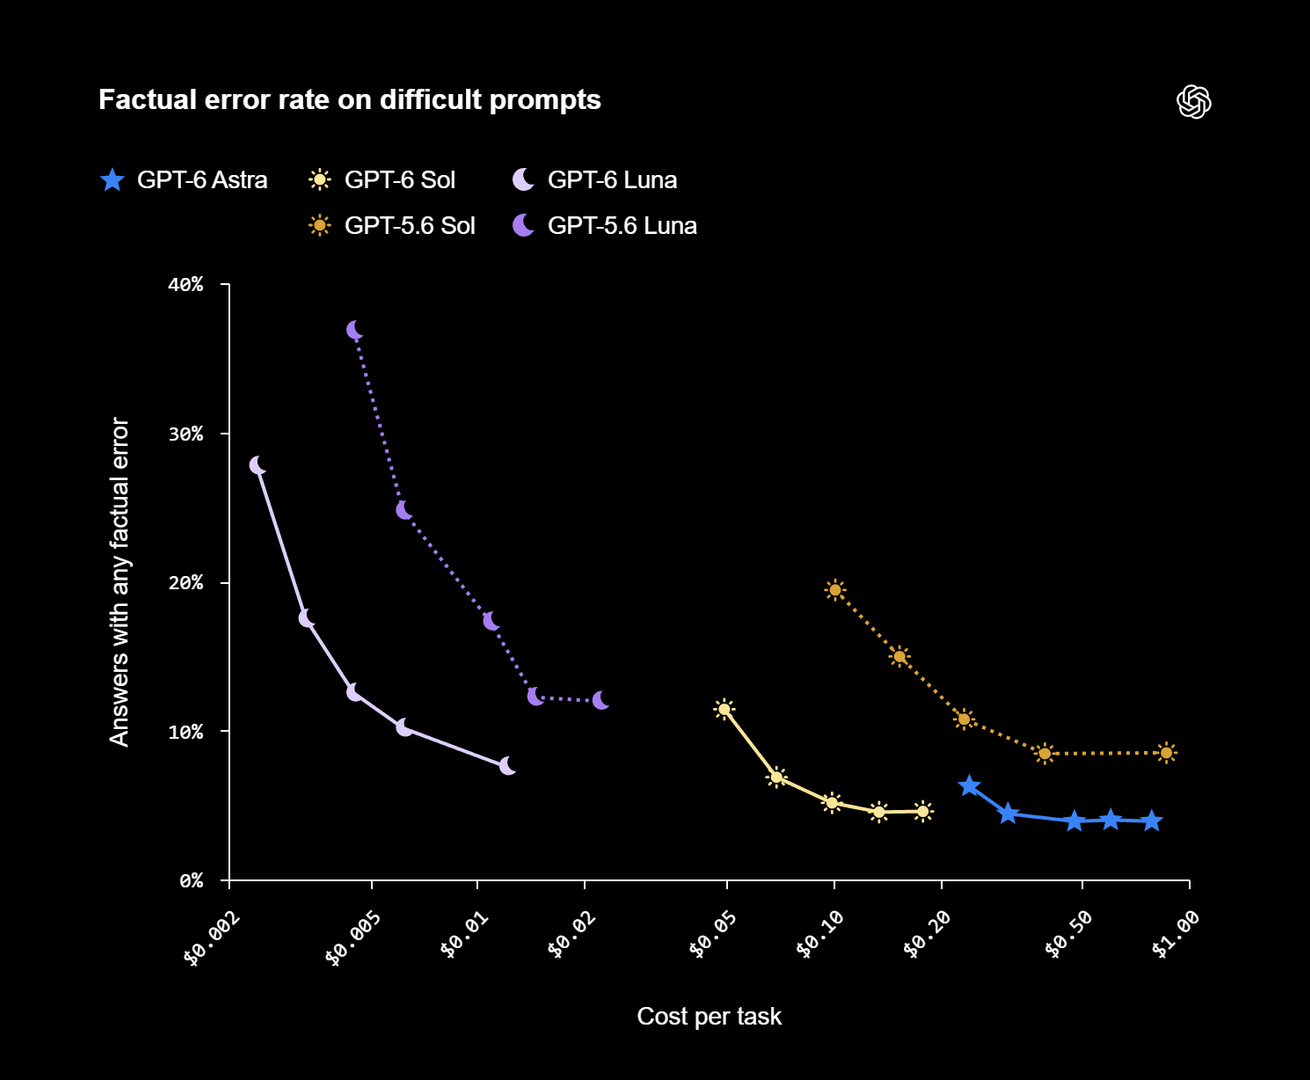
Luna enregistre à son tour une amélioration et, aux niveaux d’effort de raisonnement les plus élevés, selon l’entreprise, atteint une fiabilité comparable à GPT-5.6 Sol avec une très grande différence de coût.
OpenAI précise cependant que l’échantillon est délibérément construit à partir de conversations problématiques et ne représente pas la fréquence des erreurs en usage ordinaire. Il s’agit d’une distinction importante : le benchmark sert à comparer des modèles dans des cas difficiles, et non à estimer directement le nombre de réponses incorrectes qu’un utilisateur moyen rencontrera.
Utilisation de l’ordinateur et agents
GPT-6 Sol et Luna s’améliorent également lors des tests utilisation de l’ordinateurc’est-à-dire dans les activités dans lesquelles le modèle doit interagir avec des interfaces et des applications pour accomplir des procédures complexes.
Sur OSWorld 2.0, dans la version hors ligne indiquée par OpenAI, GPT-6 Sol en mode xhigh obtient 60,5 %. Claude Opus 5 en mode moyen atteint 60,3% dans la même comparaison, tandis qu’OpenAI attribue un coût par tâche inférieur d’environ 80% à Sol.
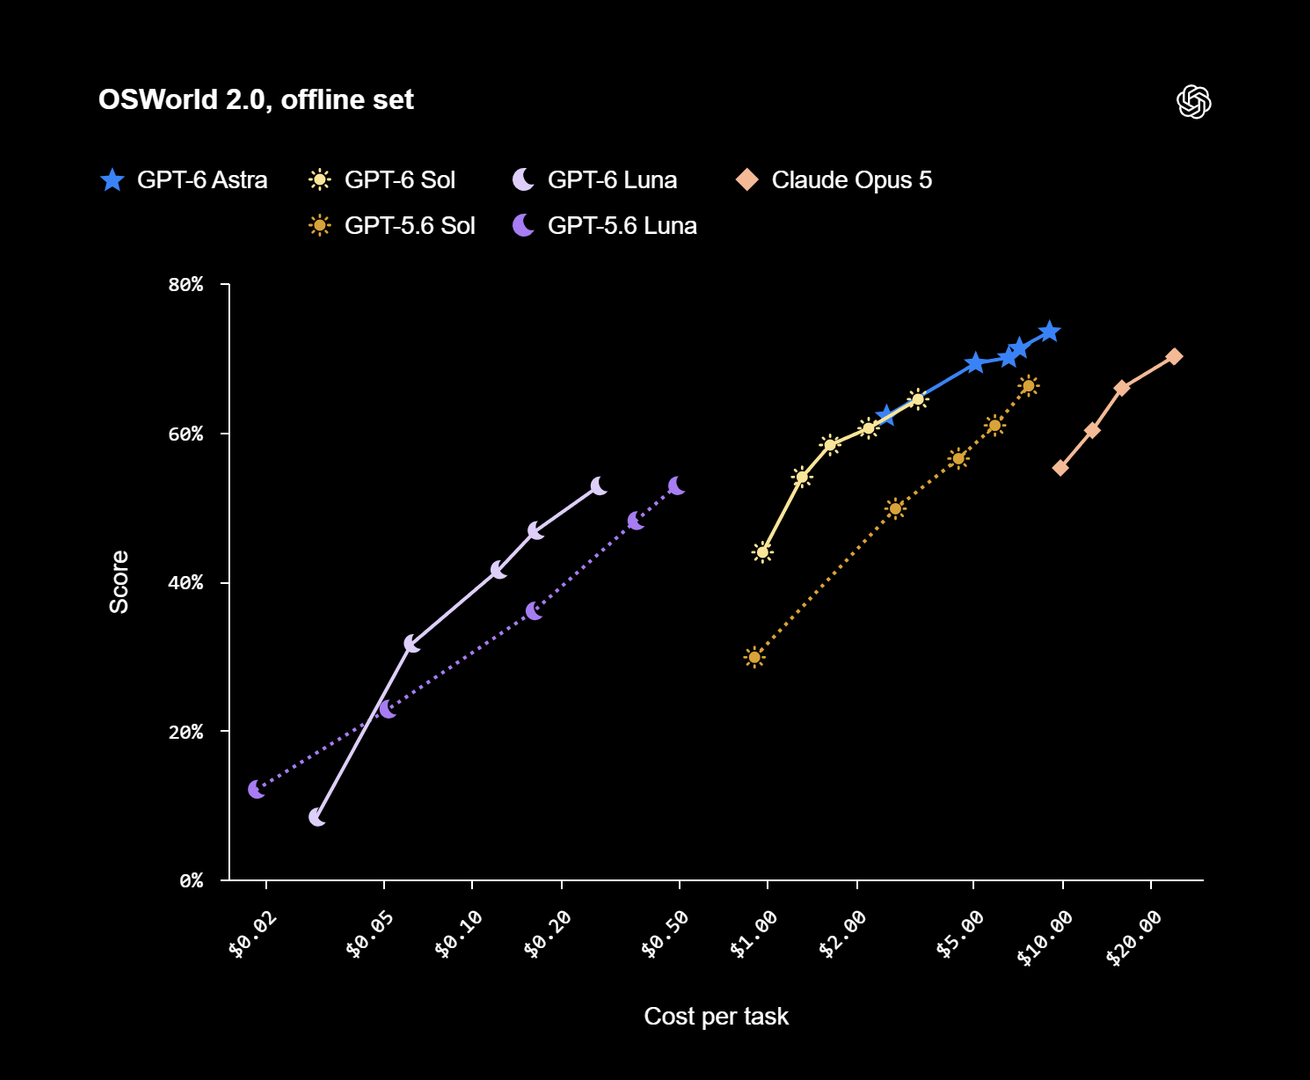
Luna en mode maximum dépasse les dépenses moyennes GPT-5.6 Sol, selon l’entreprise, d’environ un dixième pour chaque tâche.
Ils étaient particulièrement pertinents pour l’adoption d’agents à grande échelle. Lorsqu’un système doit ouvrir des applications, lire des informations, remplir des formulaires ou combiner plusieurs outils, le coût ne dépend pas d’une seule réponse. Chaque action peut nécessiter de nouveaux jetons et de nouvelles inférences. Réduire le prix du modèle tout en conservant des performances suffisantes peut donc impacter directement l’économie d’une application.
La mise en cache peut réduire davantage les dépenses
Parallèlement à la baisse de prix, OpenAI ajoute des modifications au mise en cache rapide. Le mécanisme permet de réutiliser des parties du contexte déjà traitées lorsqu’une conversation ou un agent envoie à plusieurs reprises les mêmes préfixes.
Pour GPT-6 la société indique une remise de 90% sur la lecture des tokens présents dans le cache. En fait, les prix officiels indiquent 0,20 dollars par million de jetons d’entrée mis en cache pour Sol et 0,01 dollars pour Luna dans la tarification standard indiquée dans le catalogue.
OpenAI a également introduit des outils pour mesurer le taux de hit de cache, identifiez les parties d’une invite qui empêchent la réutilisation du contexte et définissez des points d’arrêt explicites. Modifiez également le effort de raisonnement ou l’activation et la désactivation des outils peuvent désormais préserver davantage le contexte déjà stocké.
GitHub est cité dans le matériel de lancement, selon lequel ces interventions auraient réduit de plus de 50 %, en quelques mois et sur des milliards de requêtes aux modèles OpenAI, la part des tokens prompts à être à nouveau traités par Copilot.
Le style des réponses change également
OpenAI prétend avoir transféré une partie du travail effectué avec Astra sur la façon dont les modèles communiquent avec Sol et Luna. L’objectif affiché est de produire des réponses plus claires, avec moins de jargon, moins de détails de faible valeur et des formulations plus courtes sans perdre d’informations utiles.
La société illustre la différence en comparant une réponse GPT-5.6 Sol à une réponse GPT-6 Sol à une demande de modification de site Web.
Dans le commentaire du test, il critique des expressions telles que «sensation de bento » Et « remodeler… autour de ce système« , jugé plus vague que la formulation du nouveau modèle. GPT-6 Sol se présente également comme plus précis dans le reporting des contrôles qu’il a effectivement effectués et des choix techniques qu’il a adoptés.
La comparaison n’est pas une référence quantitative et OpenAI lui-même reconnaît que le style contient une composante subjective. Cependant, cela montre une direction claire : l’optimisation des modèles ne concerne pas seulement les scores et les coûts, mais également la quantité de texte nécessaire pour accomplir une tâche.
Disponibilité et nouvelle économie des modèles
GPT-6 Sol et GPT-6 Luna ont été mis à disposition le 22 septembre dans l’API avec identifiants gpt-6-sol Et gpt-6-luna. OpenAI a également annoncé sa distribution dans ChatGPT Work et Codex pour les utilisateurs Plus, Pro, Business, Enterprise et Edu, tandis que Luna est également prévue pour les utilisateurs Free and Go dans l’application de bureau.
Le lancement montre à quel point la concurrence entre les modèles d’IA évolue. La capacité maximale reste importante pour les problèmes les plus difficiles, mais les agents et applications utilisés au quotidien dépendent de plus en plus du coût nécessaire pour atteindre un certain niveau de performance.
Sol et Luna ont été créés pour cette gamme : moins chers qu’Astra et leurs prédécesseurs, avec un niveau de capacité qu’OpenAI vise à rendre suffisant pour une part croissante du travail effectué par les logiciels et les développeurs.
Pour les entreprises, la conséquence est mesurable notamment sur les gros volumes. Une différence de quelques centimes importe peu sur une seule demande ; cela devient pertinent lorsqu’un agent génère des millions d’appels, maintient de longs contextes et travaille sur de nombreuses itérations. C’est sur cette combinaison de capacité, de mise en cache et de coût par tâche que GPT-6 Sol et Luna devront démontrer leur valeur dans une utilisation réelle.