La conception d’une puce IA prend généralement des années. OpenAI a trouvé un raccourci assez évident : utiliser sa propre IA pour le faire
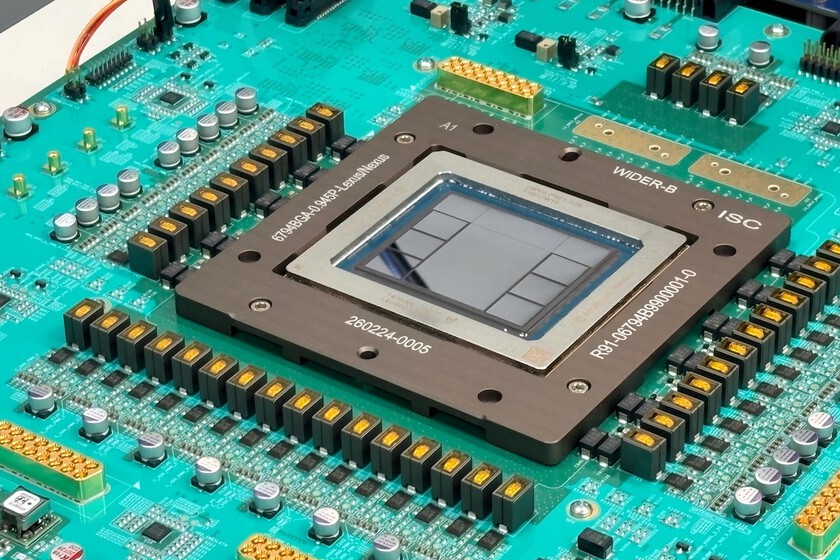
Il y a près d’un mois, OpenAI a révélé au monde certains détails de Jalapeño, sa première puce d’IA propriétaire, développée en collaboration avec Broadcom. Pour une entreprise, fabriquer une puce est une véritable étape qui nécessite du temps, de l’argent et plusieurs générations pour peaufiner le composant.
Pourtant, l’entreprise dirigée par Sam Altman est allée à une vitesse vertigineuse : du concept architectural au silicium en moins de 20 mois, et du code à la fabrication en seulement neuf mois. Quel est ton secret ? Sans surprise, utilisez vos propres modèles d’IA comme outil de conception. Richard Ho, vice-président du matériel chez OpenAI, a déclaré : « les modèles donnent des super pouvoirs à nos ingénieurs ».
La puce. Jalapeño atteint jusqu’à 13,4 pétaflops de calcul 4 bits, accédant à 232 gigaoctets de mémoire la plus avancée disponible et s’y connectant à 15,4 téraoctets par seconde. Quant à la latence, elle la réduit de bout en bout jusqu’à 3,6 fois par rapport au GB300 de Nvidia, la puce dont dépend actuellement OpenAI, et cela également en consommant moins d’énergie, selon les données publiées par OpenAI lui-même.
Vers au revoir à Nvidia. Jalapeño a été officiellement annoncé le 24 juin 2026 et marque la première étape d’OpenAI vers un sevrage de Nvidia et la fabrication de son propre matériel. Il est fabriqué chez TSMC et fait partie d’un plan d’infrastructure à grande échelle depuis plusieurs années avec Broadcom.
De nos jours, presque toutes les grandes entreprises technologiques dignes de ce nom ont fait leurs premiers pas dans la conception de leurs propres puces pour l’IA, précisément pour moins dépendre de Nvidia, le grand bénéficiaire du boom du secteur : il y a le TPU de Google ou le Maia de Microsoft. La vraie différence dans le cas d’OpenAI est la vitesse : ce qui a été presque vu et ce qui n’a pas été vu.
Comment diable ont-ils pu faire ça si vite ? La réalité rend justice à ces déclarations grandioses du vice-président du matériel d’OpenAI. L’équipe de conception de Jalapeño comptait en moyenne moins de 100 personnes tout au long du projet, et le travail était partagé avec Broadcom : tandis que les gens d’Altman étaient en charge de la conception du système, Broadcom était responsable de la partie physique.
Ce que l’IA a accéléré, c’est le front-end de la conception, la phase d’écriture du code de la puce, en s’appuyant sur des outils comme XLS. Comme l’explique Chris Leary d’OpenAI : « L’IA était bien meilleure dans ce qui ressemblait à un logiciel… XLS ressemble en quelque sorte à un logiciel, donc il en a bénéficié. »
Il y a des choses que l’IA ne peut toujours pas faire. Si l’IA a été d’une grande aide sur le front-end, sa contribution au back-end a été beaucoup plus discrète : cette phase a continué de dépendre en grande partie de Broadcom et des ingénieurs humains. Ho et Leary sont clairs : le travail de l’ingénieur reste essentiel et, aujourd’hui, irremplaçable par l’IA.
« Nous ne disons pas que n’importe qui peut créer des puces accélératrices d’IA/ML de nouvelle génération en utilisant uniquement le Codex. Nous disons des choses très concrètes sur la manière de tirer le meilleur parti du Codex et sur la manière dont nous nous sommes concentrés sur une petite équipe et des délais rapides pour obtenir des résultats de qualité », résume Ho. En résumé : l’IA a multiplié la productivité de petites équipes hautement qualifiées, mais elle n’automatise pas la conception des puces du début à la fin.
À Simseo | Les puces d’IA chinoises visaient à être une bouée de sauvetage pour l’industrie. Maintenant que l’oxygène coûte 50 % plus cher
À Simseo | L’IA est la nouvelle ruée vers l’or et Fujitsu a un plan : ramener le Japon aux jours dorés avec sa puce Monaka
Couverture | OpenAI